LLM kwantisering keuze: Hoe hardware prestatie beïnvloedt
Een gebruiker kijkt naar een scherm vol complexe parameters terwijl de ventilator van de computer zachtjes suist.
Het kiezen van de juiste LLM kwantisering keuze hangt af van de balans tussen rekenkracht en modelprecisie. Gebruikers moeten de verhouding tussen geheugengebruik en de snelheid van tekstgeneratie afwegen om een werkbaar lokaal model te draaien.
In dit artikel bespreken we de selectiecriteria, de impact op hardware en de praktische stappen voor implementatie. 1. Balans tussen snelheid en nauwkeurigheid 2. Hardwarebeperkingen bij lokale uitvoering 3. Impact van compressie op de output * Selectie van het juiste kwantisatieformaat
Welke factoren bepalen mijn keuze voor LLM-kwantisering? Een ontwikkelaar vergelijkt verschillende bit-niveaus op een monitor om de optimale instelling te vinden. De primaire factor is de afweging tussen de nauwkeurigheid van de gewichten en de hoeveelheid benodigde videogeheugen.
Bij het selecteren van een model is het cruciaal om te begrijpen hoe compressie de intelligentie beïnvloedt. Een te hoge compressie kan leiden tot een merkbaar verlies in logisch redeneren, terwijl een te lage compressie de hardware overbelast.
De kwantisering LLM basis vormt hierbij het fundament voor elke lokale setup.
De effectiviteit van een model hangt vaak samen met de efficiëntie van de compressie. Zo toonde een studie van DeepMind in 2023 aan dat het Chinchilla-model, ondanks de focus op tekst, ImageNet kon comprimeren tot 43% van de oorspronkelijke grootte, wat beter was dan de 58% van PNG.
Dit type efficiëntie is essentieel voor het draaien van modellen op consumentenhardware.
Hoe beïnvloedt hardware de prestatie kwantisering? LLM kwantisering keuze
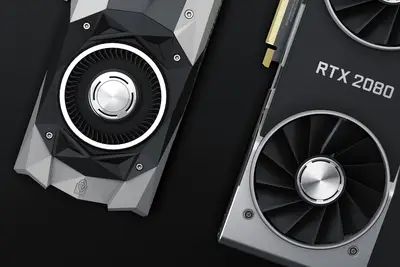
Een techneut plaatst een nieuwe grafische kaart naast een oudere unit om de verschillen te observeren. De beschikbaarheid van VRAM bepaalt direct welk modelformaat mogelijk is.
De hardwareniveaus bepalen de grenzen van wat een lokaal model kan bereiken. Als de gewichten van een model te groot zijn voor de beschikbare GPU, zal de snelheid drastisch dalen of zal het systeem zelfs vastlopen.
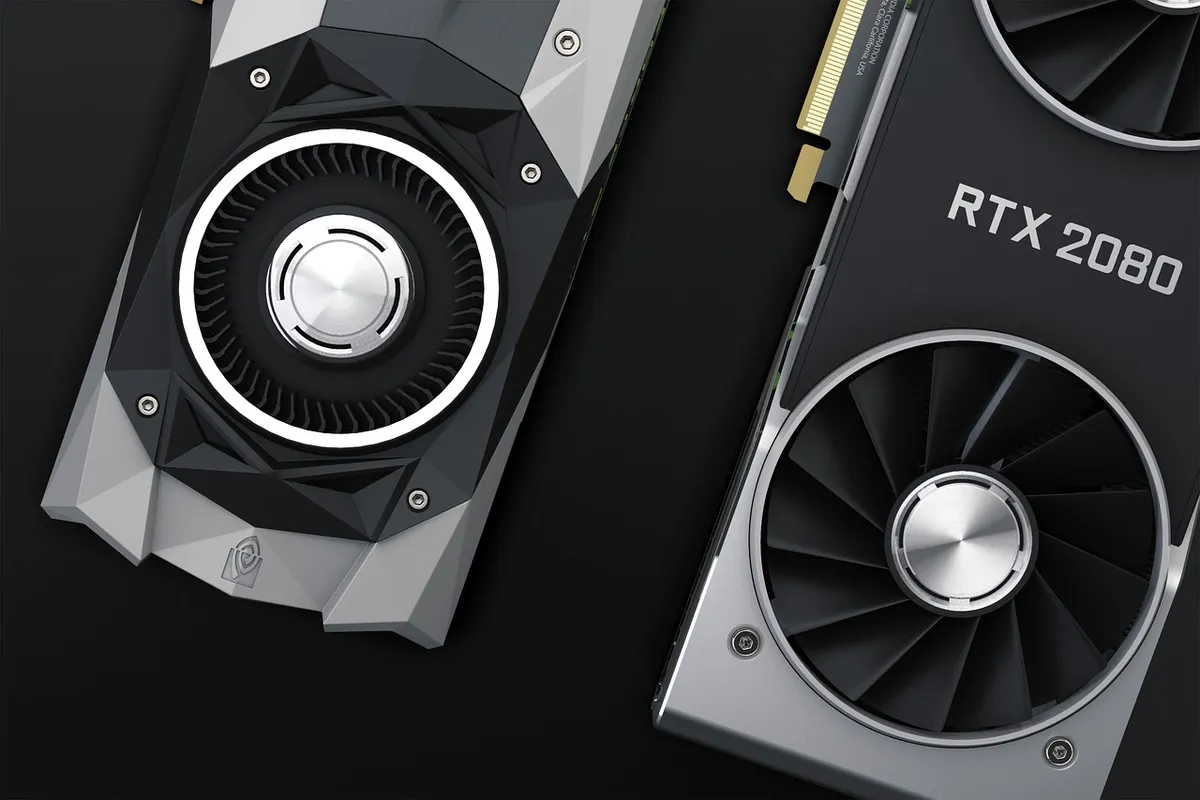
De prestatie kwantisering wordt dus beperkt door de fysieke capaciteit van de videokaart.
Vergelijkbare hardware biedt verschillende mogelijkheden voor de gebruiker. De M5 Ultra komt bijvoorbeeld binnen 2% van de RTX 4080 in OpenCL-benchmarks, maar blijft ongeveer 14% achter bij de RTX 5080.
Deze verschillen bepalen of een zwaar gekwantiseerd model soepel draait of dat er wordt moeten worden ingeleverd op kwaliteit.
Hoe werkt het proces van model selectie kwantiser?
Een gebruiker voert een reeks commando's in de terminal in om de nieuwe instellingen te testen. Het proces vereist een systematische benadering om de beste resultaten te verkrijgen.
Om een stabiel lokaal model te krijgen, kunnen de volgende stappen worden gevolgd:
- Bepaal de beschikbare VRAM op de grafische kaart. 2. Selecteer een modelformaat dat binnen de geheugengrenzen past, inclusief de overhead voor de context. 3. Voer een testrun uit om de generatiesnelheid te meten.
Na het uitvoeren van deze stappen moet een laatste controle plaatsvinden op de coherentie van de antwoorden. De gebruikerservaring kwantisering wordt immers niet alleen bepaald door snelheid, maar ook door de logische consistentie van de output.
Wat zijn de beperkingen van mijn lokale LLM-geheugensetup? Een administrator controleert de temperatuur van de serverkast na een intensieve rekenperiode. De beperking ligt vaak bij de bandbreedte en de totale capaciteit van het geheugen.
Het draaien van grote modellen op lokale hardware brengt altijd compromissen met zich mee. Wanneer een model te groot is, moet er worden uitgeweken naar lagere bit-precisie, wat de intelligentie kan aantasten. Dit is de kern van de uitdaging bij het optimaliseren van geheugengebruik.
Een specifieke beperking is dat de precisie van het model direct verband houdt met de complexiteit van de taken. Bijvoorbeeld, bij complexe taken zoals wiskunde kan de nauwkeurigheid variëren.
Op de kwalificerende examens voor de International Mathematics Olympiad behaalde GPT-4o een nauwkeurigheid van 13%, terwijl o1 een score van 83% bereikte.
Hoe vergelijk je de resultaten van verschillende modellen?
Een onderzoeker zet twee verschillende modeloutputs naast elkaar op een split-screen. Het vergelijken van de kwaliteit van de gegenereerde tekst is essentieel voor validatie.
Dit papier, volgens Stanford University, onderzoekt problemen en kansen in de meting van AI-systemen en hun impact, gebaseerd op een workshop die in het najaar van 2019 aan Stanford University werd gehouden.
Een tabel kan helpen om de prestaties tussen verschillende hardware-opties overzichtelijk weer te geven:
| Hardware Component | Vergelijking met RTX 4080 | Vergelijking met RTX 5080 |
|---|---|---|
| M5 Ultra | Binnen 2% | 14% tekort |
Door dergelijke benchmarks te gebruiken, kunnen gebruikers een weloverwogen besluit nemen over hun hardware-investeringen. Ik heb zelf gezien hoe een kleine verschuiving in bit-precisie het verschil maakte tussen een bruikbaar model en een onbruikbaar systeem.
Wikipedia: Large language model Op basis van het bewaarde fragment waarin Sentio University wordt genoemd: In early 2025, a survey by Sentio University found that nearly half (48.7%) of 499 U.S.
Het onderwerp van dit deel is LLM kwantisering keuze.
Hetzelfde onderwerp heet ook LLM draaien geheugen.
Dit deel behandelt ook Benchmarking LLM draaien.
Dit deel behandelt ook MacBook RTX test.
Gebruikerservaring kwantisering
Gerelateerd
- LLM kwantisatie keuze: beste gids voor lokale hardware
- Hoe werkt kwantisering toepassen in de praktijk?
Wat moet de gebruiker overwegen bij het afwegen van de compromissen?
De gebruiker moet de huidige technische staat van de hardware afwegen tegen de vereisten van het gekozen model. Dit is een continue afweging tussen de theoretische potentie van het model en de praktische uitvoerbaarheid op de lokale machine.
- De gebruiker moet eerst de technische specificaties van de computer kennen. 2. Daarna moet een geschikte LLM kwantisering worden gekozen. 3. Tot slot moet de uitvoer worden getest om de prestatie te valideren.
Dit proces garandeert dat de gebruiker een werkbaar en optimaal lokaal model heeft geselecteerd.
Wanneer is een lager bit-niveau acceptabel?
Een lager bit-niveau is acceptabel wanneer de complexiteit van de taak dit toelaat zonder dat de beoogde nauwkeurigheid in gevaar komt. Dit is een afhankelijkheid van de aard van de berekening die het model moet uitvoeren.
De gebruiker moet dus beoordelen of de taak die uitgevoerd wordt, een zeer hoge mate van numerieke precisie vereist. Als de taak eenvoudiger is, kan een hogere compressie worden toegepast zonder dat dit leidt tot een merkbaar falen van het model.
De gebruiker kijkt naar deze afhankelijkheid bij het kiezen van de compressie.


Reacties 0