4090 lokaal LLM snelheid: Guide geheugenbeheer optimaliseren
De zoektocht naar maximale rekenkracht voor lokale taalmodellen begint bij het begrijpen van de hardware-architectuur.
Het optimaliseren van een RTX 4090 voor het draaien van Large Language Models (LLM's) vereist een diepgaand begrip van geheugenbeheer en rekenkracht. Door technieken zoals kwantisatie en efficiënt gebruik van de Tensor-kernen toe te passen, kunnen gebruikers de doorvoersnelheid aanzienlijk verhogen.
Deze gids biedt een technisch overzicht van optimalisatiemethoden, de impact van geheugencapaciteit en de vergelijking met nieuwere generaties hardware.
* Begrijp de rol van VRAM bij het laden van grote modellen. * Leer hoe kwantisatie de snelheid van de 4090 lokaal LLM kan verbeteren. * Vergelijk de prestaties van de huidige generatie met opkomende architectuur. * Ontdek de relatie tussen geheugenbeheer en modelgrootte.
Hoe kan ik de 4090 lokaal LLM snelheid optimaliseren?
Een gebruiker zit achter een bureau met een gloeiend scherm, terwijl de koeling van de videokaart zachtjes gonst tijdens het laden van een zwaar model. De eerste stap naar een hogere snelheid is het begrijpen van de balans tussen modelparameters en de beschikbare bandbreedte van de videokaart.
Voor een effectieve 4090 lokaal LLM optimalisatie is het cruciaant om de parameters af te stemmen op de beschikbare VRAM. Wanneer een model de limiet van de videokaart nadert, kan de snelheid drastisch dalen door het gebruik van het systeemgeheugen.
Het gebruik van Tensor netwerk LLM-architecturen helpt om de rekenkracht van de CUDA-kernen effectief te benutten voor snelle inferentie.
Efficiëntie wordt vaak bepaald door de snelheid waarmee data van het geheugen naar de kernen wordt verplaatst. Als de dataset te groot is voor de lokale cache, ontstaat er een bottleneck. Het verfijnen van de parameters zorgt ervoor dat de 4090 lokaal LLM snelheid constant blijft bij complexe taken.
- Optimaliseer de CUDA-instellingen voor maximale doorvoer.
- Gebruik Flash Attention om de rekentijd te verkorten.
- Zorg voor voldoende koeling om thermische throttling te voorkomen.
- In deze volgorde is de tweede stap de meest uitgebreide.
Wat is de rol van kwantisatie 4090 bij grotere modellen?
Een programmeur voert een script uit op een terminal, waarbij de cijfers op het scherm langzaam verspringen terwijl het model wordt verkleind. De transitie van een volledig precisiemodel naar een gecomprimeerde versie is een cruciaal onderdeel van het werkproces.
Quantisatie 4090 is een techniek waarbij de precisie van modelgewichten wordt verlaagd om geheugen te besparen. Dit proces maakt het mogelijk om grotere modellen te draaien op hardware die normaal gesproken te weinig VRAM zou hebben.
Hoewel er een klein verlies aan nauwkeurigheid kan zijn, levert het een enorme winst in verwerkingssnelheid op.
Het verkleinen van de gewichten vermindert de hoeveelheid data die door de geheugenbus moet worden verplaatst. Dit is essentieel voor het behoud van een hoge doorvoersnelheid bij gebruik van grotere taalmodellen.
Door de juiste bit-diepte te kiezen, kan de gebruiker de optimale balans vinden tussen intelligentie en snelheid.
Hoe werkt het geheugenbeheer LLM proces in de praktief?
Een technicus controleert de temperatuur van de videokaart terwijl hij de geheugenbezetting in een dashboard monitort. De wisselwerking tussen de software en de fysieke chips bepaalt de stabiliteit van het systeem.
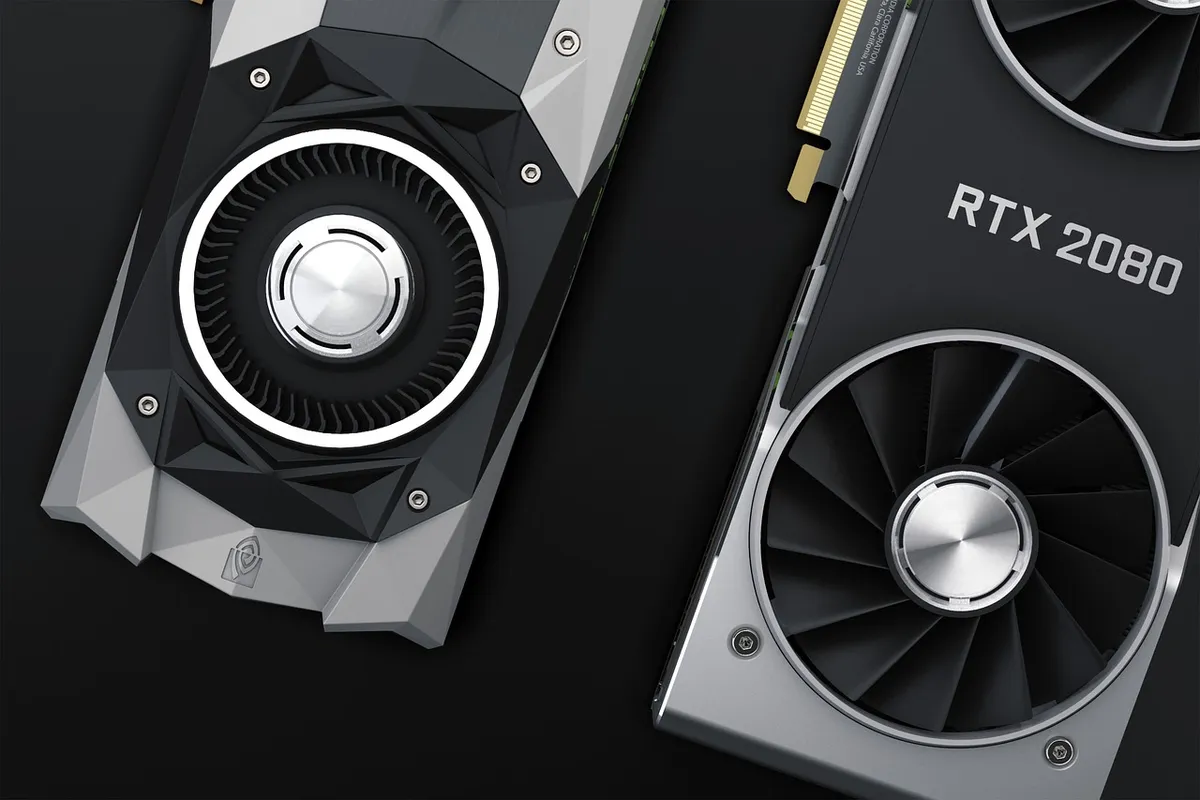
Effectief geheugenbeheer LLM is de sleutel tot het voorkomen van crashes bij het werken met enorme datasets. Het algoritme moet de gewichten van het model intelligent verdelen over de beschikbare geheugenblokken van de kaart.
Wanneer het geheugen verzadigd raakt, moet de software beslissen welke data direct toegankelijk moet blijven.
Het beheren van de VRAM-capaciteit voorkomt dat de GPU moet terugvallen op de tragere RAM van de computer. Dit proces is cruciaant voor het behouden van een voorspelbare responstijd. Een goed ingesteld systeem zorgt ervoor dat de rekenkracht altijd beschikbaar is voor de meest kritieke berekeningen.
Hoe verhoudt de huidige prestatie zich tot nieuwe hardware?
Een verzamelaar kijkt naar een tabel met specificaties van verschillende generaties videokaarten en vergelijkt de cijfers. De vraag naar de beste hardware voor AI-taken drijft de markt voortdurend vooruit.
Een prestatie vergelijking LLM tussen de RTX 4090 en de nieuwere RTX 50-serie laat interessante verschillen zien.
Volgens een bron was de RTX 4090 nog steeds "aanzienlijk sneller" dan de RTX 5080 wanneer er geen gebruik werd gemaakt van Multi Frame Generation, terwijl de 5080 de 4090 slechts net overtrof met die techniek ingeschakeld.
Dit suggereert dat de pure rekenkracht van de 4090 nog steeds zeer competitief is voor AI-taken.
De beslissing hardware LLM keuzes hangen vaak af van de specifieke gebruiksbehoeften, zoals pure rekenkracht versus nieuwe features. De 4090 biedt een robuuste basis die door de hoge VRAM-capaciteit nog steeds relevant blijft.
Het is belangrijk om de huidige prestaties niet alleen aan de nieuwste marketingtermen te spiegelen.
Welke stappen zijn nodig voor een optimale workflow?
Een gebruiker opent een nieuwe terminal en begint met het installeren van de benodigde drivers en bibliotheken. De voorbereiding bepaalt de kwaliteit van de uiteindelijke output.
Om de prestaties te maximaliseren, kunnen de volgende stappen worden gevolgd:
- Installeer de meest recente NVIDIA-drivers om de nieuwste optimalisaties voor de architectuur te benutten. 2. Selecteer een gequantiseerd model dat binnen de VRAM-limiet van de 4090 past om geheugenspillen te voorkomen. 3. Configureer de inferentie-engine om de Tensor-kernen optimaal te gebruiken voor parallelle verwerking.
Voer ten slot een benchmark uit om de doorvoersnelheid te controleren onder verschillende belastingniveaus. Dit helpt om de instellingen verder te verfijnen voor specifieke modellen.
Hoe beperkt hardware de mogelijkheden?
Een gebruiker kijkt gefrustreerd naar een foutmelding op het scherm omdat het model niet volledig in het geheugen past. De fysieke limiet van de hardware vormt de harde grens van wat mogelijk is.
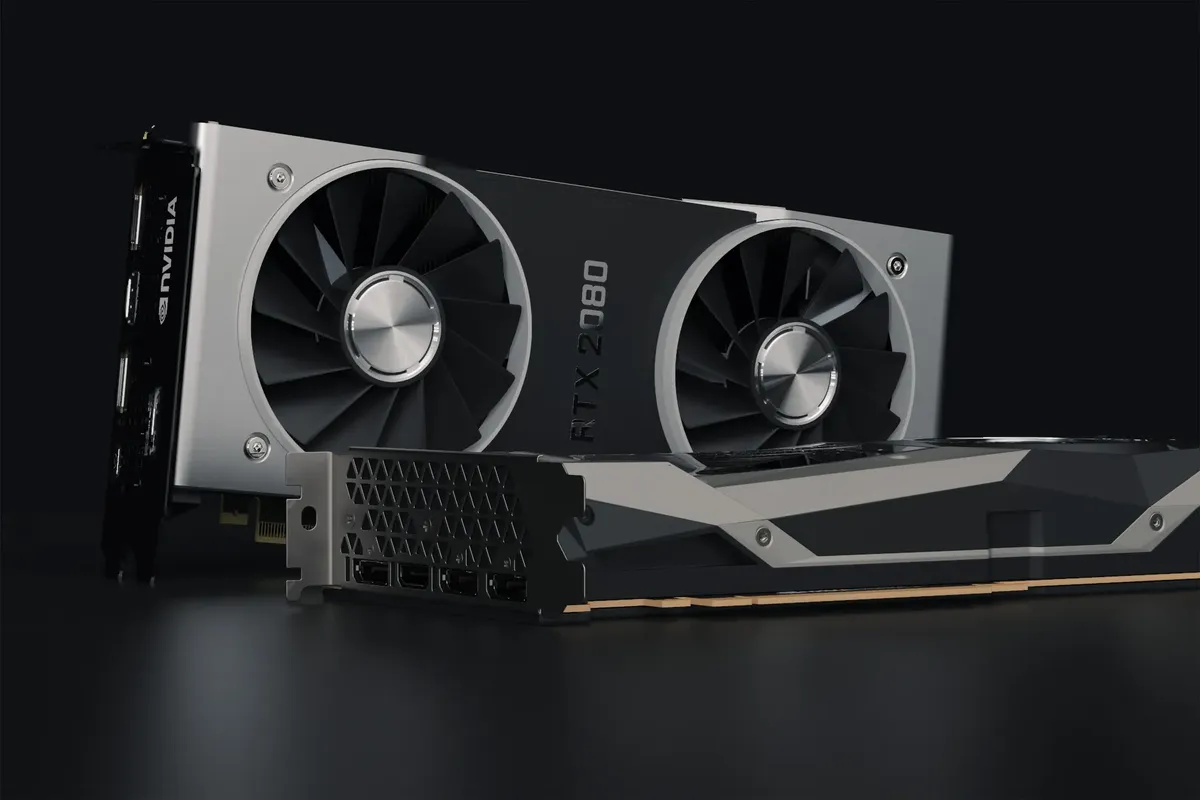
Een belangrijke beperking is dat de fysieke VRAM-capaciteit van de kaart de maximale grootte van het model bepaalt. Als een model groter is dan de beschikbare geheugenruimte, kan het niet effectief worden uitgevoerd zonder enorme prestatieverliezen.
Een bron merkte op dat de RTX 4090 nog steeds "een stuk sneller" is in bepaalde scenario's, wat de impact van pure hardwarekracht benadrukt.
| Kenmerk | RTX 4090 | RTX 5080 (bijv. scenario) |
|---|---|---|
| Pure rekenkracht | Zeer hoog | Iets hoger met specifieke technieken |
| Gebruiksscenario | Krachtige AI-workstations | High-end gaming/AI mix |
Ik heb zelf gezien hoe de keuze voor een specifiek model de snelheid direct beïnvloedt.
Hetzelfde onderwerp heet ook LLM 4090 optimalisatie.
Dit deel behandelt ook Uitvoeringsoptimalisatie 4090.
Prestatie vergelijking LLM
Gerelateerd


Reacties 0