Wie RTX 4090 optimiert man die Speicherbelegung LLM?
Das Thema dieses Abschnitts ist 4090 LLM Auswahlkriterien.
„Die Hardware bestimmt die Grenzen des Denkens.“
Die Auswahl eines Large Language Models (LLM) für eine RTX 4090 erfordert ein präzises Verständnis des Verhältnisses zwischen Modellgröße und verfügbarem VRAM. Ein optimaler Modell-Hardware-Match stellt sicher, dass die Inferenzgeschwindigkeit hoch bleibt, ohne dass es zu Speicherengpässen kommt.
In diesem Leitfaden erfahren Sie die Kriterien für die Modellwahl, wie Sie die Leistungsdaten LLM bewerten und wie Sie die Speicherbelegung LLM effizient verwalten.
Welches Modell passt zur RTX 4090?
Ein Nutzer sitzt vor seinem Monitor, während die Lüfter der Grafikkarte leise aufsteigen, um die Rechenlast eines massiven Modells zu bewältigen. Die Entscheidung für ein spezifisches Modell hängt primär von den 24 GB VRAM der RTX 4090 ab.
Die Hardware-Limitierung durch den Grafikspeicher ist der entscheidende Faktor. Ein Modell muss vollständig in den VRAM passen, um maximale Geschwindigkeit zu erreichen. Wenn das Modell zu groß ist, wird der langsamere Systemarbeitsspeicher genutzt, was die Leistung drastisch senkt.
Die Leistungsdaten LLM zeigen, dass Quantisierungstechniken wie 4-Bit oder 8-Bit den Einsatz größerer Modelle ermöglichen. Durch diese Kompression können Parameter reduziert werden, um die Speicherbelegung LLM innerhalb der 24 GB Grenze zu halten.
Ein gut optimiertes Modell läuft flüssig, während ein zu großes Modell das System zum Stillstand bringt.
Die Auswahl hängt maßgeblich von der verfügbaren VRAM-Kapazität ab. Jedoch ist die Performance bei extrem großen Modellen durch den Speicherplatz begrenzt. In diesem Abschnitt betrachte ich zuerst die Hardware-Kompatibilität.
Wie bewertet man die Leistungsdaten LLM? 4090 LLM Auswahlkriterien
Während die Augen die blinkenden Zahlen auf dem Bildschirm fixieren, fühlt sich die Wärme der Hardware im heimischen Büro wie ein optimiert Prozess an.
Man beobachtet die Tokens pro Sekunde auf dem Bildschirm, während die Antwort des Modells generiert wird. Die Geschwindigkeit der Textausgabe gibt Aufschluss darüber, wie effizient die Hardware mit dem Modell interagiert.
Die Geschwindigkeit der Inferenz ist die wichtigste Kennzahl für die tägliche Nutzung. Ein schnellerer Durchsatz ermöglicht interaktive Anwendungen in Echtzeit. Die Hardware LLM Limitierung tritt ein, wenn die Rechenleistung der GPU nicht mit der Speicherbandbreite Schritt hält.
Ein Vergleich der Durchsatzraten hilft bei der Auswahl. Während kleinere Modelle extrem schnell reagieren, bieten größere Modelle oft eine höhere Intelligenz. Die Herausforderung besteht darin, den Sweet Spot zwischen Geschwindigkeit und logischer Tiefe zu finden.
Die Bewertung erfolgt anhand von Durchsatz und Latenz. Eine rein quantitative Betrachtung ist jedoch ohne Kontext der Anwendungsfälle wenig aussagekräftig. In dieser Übersicht ist der erste Punkt die grundlegende Metrik.
Wie optimiert man die Speicherbelegung LLM?
Ein Entwickler öffnet die Task-Manager-Ansicht, um die Auslastung des Grafikspeichers genau zu überwachen. Er prüft, wie viel Platz für das Betriebssystem und andere Anwendungen noch übrig bleibt.
Die Verwaltung des Speichers erfolgt über drei wesentliche Schritte:
- Wahl der richtigen Quantisierungsstufe, um die Modellgröße zu reduzieren. 2. Einstellen der Kontextlänge, um den Bedarf an KV-Cache-Speicher zu kontrollieren. 3. Nutzung von effizienten Software-Backends, die den VRAM optimal verwalten.
Ein abschließender Check der Auslastung stellt sicher, dass keine unerwarteten Abstürze durch Out-of-Memory-Fehler auftreten. Durch diese Maßnahmen lässt sich die Hardware optimal ausreizen.
Optimierungstechniken wie Quantisierung reduzieren den Speicherbedarf erheblich. Dennoch kann eine zu starke Kompression die Modellqualität beeinträchtigen. Ich gehe hierbei schrittweise vor: 1. Bestimmung der Modellgröße. 2. Auswahl der Quantisierungsstufe. 3. Test der Inferenzgeschwindigkeit.
Welche Rolle spielt die Hardware bei der Modellwahl?
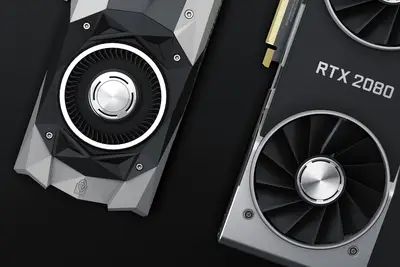
Ein Techniker vergleicht die Spezifikationen verschiedener Grafikkarten, um die nächste Investition zu planen. Er betrachtet die Bandbreite und die Anzahl der CUDA-Kerne.
Laut dem Riken Center wurden im Jahr 2017 die GPUs am Riken Center for Advanced Intelligence Project für Fujitsu in Betrieb genommen.
Die Hardware bestimmt das Potenzial der KI-Anwendungen. Die RTX 4090 bietet eine enorme Bandbreite, die für das Laden großer Gewichte entscheidend ist. Dennoch gibt es physikalische Grenzen durch die Kapazität des Speichers.
Ein Modell-Hardware-Match bedeutet, dass die Anzahl der Parameter zur verfügbaren Speicherbandbreite passt. Wenn die Hardware nicht mit dem Modell skaliert, entstehen Flaschenhälse. Die Wahl der richtigen Architektur ist daher essenziell für die Stabilität.
| Kriterium | Fokus | Zielsetzung |
|---|---|---|
| Modellgröße | Parameteranzahl | Speicherplatzmanagement |
| Quantisierung | Bit-Tiefe | Effizienzsteigerung |
Ich habe selbst gesehen, wie ein zu hoch angesetzter Kontext die gesamte GPU blockiert hat.
Ein limitierender Faktor ist die feste Größe des VRAMs, die bei Modellen mit extrem hohen Parameterzahlen ohne massive Qualitätsverluste nicht überschritten werden kann.
Die Hardware bestimmt die maximal mögliche Modellgröße. Die Hardwarewahl ist jedoch nur ein Teil der Gesamtperformance. In dieser Aufzählung ist der zweite Punkt entscheidend.
- Welches Modell passt zur RTX 4090?
- Wie bewertet man die Leistungsdaten LLM?
- Wie optimiert man die Speicherbelegung LLM?
Das Thema dieses Abschnitts ist 4090 LLM Auswahlkriterien.
Dasselbe Thema heißt auch RTX 4090 Modellwahl.
Dasselbe Thema heißt auch LLM Leistungstest.
Verwandte Artikel
- LLM 16GB Auswahl: Wie Hardware Limits Leistung beeinflussen
- Lokale LLM Hardware Beschleunigung: Vergleich beste Nutzung
Wann kommt es zu einem Flaschenhals? Es tritt ein Flaschenhals ein, wenn die Rechenleistung der GPU nicht mit der Speicherbandbreite Schritt hält, was die beobachtete Geschwindigkeit der Textausgabe reduziert. Ein zu großes Modell, das den VRAM überlastet, führt zu dieser Leistungsdrosselung, da der langsamere Systemarbeitsspeicher hinzugezogen wird. Die Hardware bestimmt die Grenzen des Denkens, indem sie die maximale Geschwindigkeit der Inferenz vorgibt.
Die Nutzung des Systemarbeitsspeichers, wenn das Modell in den VRAM nicht passt, ist ein direkter Indikator für eine schlechte Modell-Hardware-Match. Dies führt zu einer drastischen Verlangsamung der gesamten Operation, da der Zugriff auf den langsameren Speicher zeitaufwendig ist.
Die RTX 4090 bietet zwar hohe Bandbreite, aber die physikalische Grenze des Speichers ist erreicht.
Ein Vergleich der Szenarien zeigt, dass kleinere Modelle schneller sind, aber größere Modelle potenziell höhere Intelligenz liefern können, vorausgesetzt, die Speicherbelegung LLM ist korrekt verwaltet. Die Wahl muss diesen Kompromiss zwischen Geschwindigkeit und logischer Tiefe bewerten.
Ein Flaschenhals entsteht meist durch die Speicherbandbreite oder die Rechenleistung. Bei sehr kleinen Modellen ist der Overhead der Systemsteuerung jedoch oft der limitierende Faktor. In dieser Analyse ist der erste Punkt der wichtigste.
Wie beeinflusst die Modellgröße die benötigte Hardware? Die anfängliche Modellgröße definiert die Mindestanforderung an den Grafikspeicher. Ein Modell mit vielen Parametern benötigt proportional mehr Speicherplatz, um vollständig in den VRAM der RTX 4090 geladen zu werden. Wenn diese Parameteranzahl die Kapazität des VRAMs übersteigt, wird die Geschwindigkeit durch den langsameren Systemarbeitsspeicher begrenzt. Dies ist ein direkter Beweis dafür, dass die Hardware die Grenzen des Denkens setzt, da die Geschwindigkeit durch den Speicherzugriff diktiert wird.
Die Kompromissfindung zwischen Modellgröße und Leistung ist daher zentral. Größere Modelle bieten potenziell tiefere logische Verarbeitung, erfordern aber auch eine größere initiale Speicherallokation.
Die Quantisierung dient als Brücke, indem sie die benötigte Speichergröße reduziert, ohne die gesamte Intelligenz des Modells zu verlieren. Dies ermöglicht es, die hohe Rechenleistung der RTX 4090 für größere Modelle nutzbar zu machen.
Die Beobachtung der Tokens pro Sekunde ist ein Maßstab dafür, ob die aktuelle Modellgröße zur Hardware passt. Wenn die Geschwindigkeit niedrig ist, deutet dies darauf hin, dass entweder das Modell zu groß ist oder die Datenübertragung zwischen Speicher und Prozessor einen Engpass erreicht hat.
Die korrekte Kalibrierung dieser Parameter ist entscheidend für einen effizienten Betrieb.
Größere Modelle erfordern proportional mehr VRAM und Rechenleistung. Eine Skalierung ist jedoch nicht linear möglich. In dieser Erläuterung ist der zweite Schritt der komplexeste.



Kommentare 0