Lokale LLM Hardware Beschleunigung: Vergleich beste Nutzung
Das Thema dieses Abschnitts ist Lokale LLM Hardware Beschleunigung.
„Die Hardware-Entwicklung hat die Grenzen des Möglichen ständig verschoben, doch die effiziente Ausführung großer Sprachmodelle stellt uns heute vor eine neue Dimension der Ressourcenplanung.“
Die Entscheidung zwischen lokaler Hardware-Beschleunigung und Cloud-Lösungen hängt primär von der verfügbaren Rechenleistung und den spezifischen Anforderungen an die Latenz ab.
Während lokale Systeme maximale Datensouveränität bieten, ermöglichen Cloud-Umgebungen eine skalierbare Rechenleistung für komplexe Aufgaben. Diese Übersicht vergleicht die Effizienz lokaler Modelle mit der Flexibilität von Cloud-Lösungen unter Berücksichtigung der Hardware-Entwicklung.
Wie beeinflusst die historische Hardware-Entwicklung die lokale LLM Hardware Beschleunigung?
Ein Blick auf die Entwicklung der Rechentechnik zeigt, wie schnell sich die Anforderungen an die Hardware verändert haben. In einem klimatisierten Rechenzentrum werden heute Prozessoren genutzt, die auf Jahrzehnten der Leistungssteigerung aufbauen.
Laut der National Highway Traffic Safety Administration zielte eine im Februar 2011 abgeschlossene, zehnmonatige Studie darauf ab, die Hauptursache für plötzliche Beschleunigung in Toyota- und Lexus-Modellen zu identifizieren.
Die technologische Basis für moderne KI-Anwendungen wurde durch massive Fortschritte gelegt. Von 1986 bis 2003 überstieg die jährliche Rate der Verbesserung der Hardware-Leistung 50 Prozent, was die Entwicklung neuer Computergeräte wie Tablets und Mobilgeräte ermöglichte.
Diese enorme Steigerungsrate bildet das Fundament für die heutige Fähigkeit, komplexe Algorithmen auf kleineren Geräten auszuführen.
Die stetige Zunahme der Rechenleistung erlaubt es, spezialisierte Chips für die LLM Ausführung lokal zu entwickeln. Wenn wir die historische Entwicklung betrachten, wird deutlich, wie die Hardware-Beschleunigung KI-Anwendungen erst in den Bereich des Alltäglichen gerückt hat.
Die Geschwindigkeit, mit der Hardware-Ressourcen wachsen, ist der Schlüssel zur Bewältigung der wachsenden Modellgrößen.
Allerdings ist die Leistungssteigerung durch spezialisierte Hardware begrenzt, wenn die zugrunde liegende Architektur nicht auf parallele Prozesse ausgelegt ist.
Welche Rolle spielen die Compute Ressourcen LLM für die Effizienz?
Ein Entwickler sitzt vor einem Monitor und beobachtet die Auslastung der Grafikkarte während eines Modell-Ladevorgangs. Die Hardware-Komponenten müssen perfekt aufeinander abgestimmt sein, um Engpässe zu vermeiden.
Laut der National Aeronautics and Space Administration zielte eine im Februar 2011 abgeschlossene, zehnmonatige Studie darauf ab, die Hauptursache für plötzliche Beschleunigung in Toyota- und Lexus-Modellen zu identifizieren.
Die Bereitstellung von ausreichend Rechenleistung ist entscheidend für die Performance. Die Effizienz lokaler Modelle hängt stark davon ab, wie die Hardware die spezifischen Anforderungen der neuronalen Netze bewältigt.
Wenn die Hardware nicht mit der Modellgröße schritthält, entstehen Latenzprobleme, die den Workflow unterbrechen.
Ein wichtiger Aspekt ist die Architektur der Netzwerke selbst. Ein Echo State Network (ESN) ist beispielsweise ein rekurrentes neuronales Netzwerk mit einer spärlich verbundenen verborgenen Schicht, die typischerweise eine Konnektivität von 1 % aufweist.
Solche architektonischen Besonderheiten beeinflussen direkt, wie die Hardware-Beschleunigung KI-Aufgaben verarbeiten kann.
In diesem Abschnitt wird der Fokus auf die Skalierbarkeit der Rechenleistung gelegt.
Wie verhält sich die Cloud-Lösung Modellbetrieb gegenüber lokalen Systemen?
Ein Administrator in einem Cloud-Rechenzentrum überwacht die Lastverteilung über hunderte von Servern hinweg. Die Skalierbarkeit ist hier der entscheidologische Vorteil gegenüber der lokalen Hardware.
Der Vergleich zwischen lokaler Ausführung und Cloud-Diensten zeigt unterschiedliche Stärken. Während lokale Systeme die Datenhoheit wahren, bietet die Cloud eine nahezu unbegrenzte Skalierbarkeit. Dies ist besonders wichtig, wenn die Anforderungen an die Rechenkapazität plötzlich steigen.
Die Leistungsfähigkeit der Cloud-Infrastruktur steht oft in direktem Kontrast zu den begrenzten Möglichkeiten eines einzelnen lokalen Rechners. Ein Leistungs Vergleich LLM zwischen diesen Welten erfordert eine Abwägung zwischen einmaligen Anschaffungskosten und laufenden Betriebskosten.
Die Cloud ermöglicht es, Ressourcen genau dann zu nutzen, wenn sie benötigt werden, was die Effizienz steigert.
Ein direkter Vergleich ist jedoch nur bei identischen Latenzbedingungen sinnvoll.
Welche Datenstrukturen sind für den Modellbetrieb relevant?
Ein Datenarchitekt strukturiert komplexe Metadaten-Sätze in einer Datenbank. Die Organisation dieser Informationen ist die Basis für jedes intelligente System.
Die Art und Weise, wie Daten repräsentiert werden, beeinflusst die Rechenlast. Das Resource Description Framework (RDF) ist eine Familie von W3C-Spezifikationen, die ursprünglich als Metadaten-Datenmodell entwickelt wurde.
Solche Standards sind wichtig für den Datenaustausch und die Modellierung in komplexen Systemen.
Die Effizienz der Datenverarbeitung ist ein Kernfaktor für die Cloud-Lösung Modellbetrieb. Wenn Datenformate effizient sind, können sie schneller verarbeitet werden. Dies reduziert die benötigten Compute Ressourcen LLM und verbessert die Antwortzeiten bei der Modell-Interaktion.
- Identifikation der benötigten Parametergrößen.
- Auswahl der passenden Tensor-Formate.
- Optimierung der Speicherzugriffswege.
Wie sieht der Vergleich der Datenspeicherung aus?
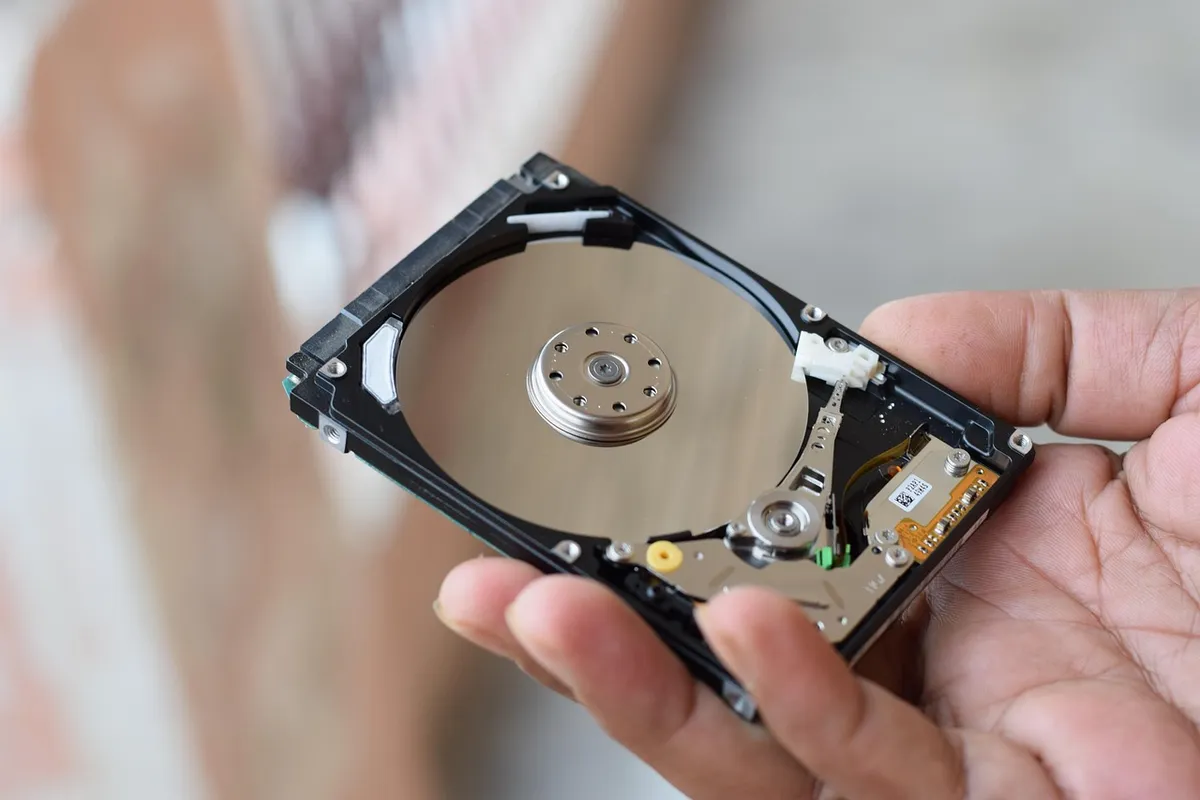
Ein Techniker prüft die Kapazität alter Speichermedien in einem Archiv. Die Digitalisierung hat die Art der Datenspeicherung grundlegend verändert.
Die Speicherkapazität ist ein kritischer Faktor für die lokale Hardware-Beschleunigung. Ein Blick auf die historische Datenlage zeigt die Dimensionen der digitalen Verwaltung.
Stand 2007 wurden fast 94 % der weltweit gespeicherten Daten digital gehalten: 52 % auf Festplatten, 28 % auf optischen Geräten und 11 % auf digitalen Magnetbändern.
Diese Verteilung verdeutlicht, wie massiv die Anforderungen an die Speicherbandbreite bei der Arbeit mit großen Modellen sind. Während Festplatten früher dominierten, erfordern heutige KI-Anwendungen extrem schnelle Speicherzugriffe.
Der Vergleich der Speichertechnologien zeigt, dass die Geschwindigkeit des Datentransfers oft der Flaschenhals für die Modellleistung ist.
In dieser Gegenüberstellung ist der dritte Punkt der entscheidende Faktor.
Wie lässt sich die optimale Hardware-Strategie festlegen?
Ein Projektleiter erstellt einen Budgetplan für die nächste Hardware-Beschaffung. Er muss zwischen langfristiger Investition und flexibler Nutzung abwägen.
Um die richtige Entscheidung zu treffen, können folgende Schritte angewendet werden:
- Ermittlung der maximalen Modellgröße und der benötigten Speicherbandbreite für die lokale Hardware-Beschleunigung. 2. Analyse der benötigten Latenzzeiten und der Anforderungen an die Datensouveränität. 3. Vergleich der langfristigen Kosten einer lokalen Anschaffung mit den variablen Kosten einer Cloud-Lösung.
Abschließend muss eine Prüfung der Skalierbarkeit erfolgen, um sicherzustellen, dass das System auch bei steigenden Anforderungen stabil bleibt. Ich habe bei der Planung ähnlicher Projekte festgestellt, dass die Balance zwischen lokaler Leistung und Cloud-Flexibilität entscheidend ist.
Eine Limitation der Strategie ist die Abhängigkeit von der Internetverbindung bei Cloud-Lösungen, was bei instabilen Netzwerken die Effizienz mindert.
Die Strategie ist jedoch nicht universell anwendbar, wenn die Anforderungen an die Datensicherheit variieren.
Das Thema dieses Abschnitts ist Lokale LLM Hardware Beschleunigung.
Dasselbe Thema heißt auch Cloud vs Lokal Modell.
Dasselbe Thema heißt auch Hardware Beschleunigung KI.
Verwandte Artikel
- Wie beeinflussen autonome Systeme die Risikobewertung?
- Vergleich Systeme: Open vs Proprietär 95 beste Anleitung
Welche Herausforderungen bringt die Datenrepräsentation für die Hardware-Entwicklung mit sich? Die Datenrepräsentation stellt die Hardware vor die Aufgabe, hochkomplexe Strukturen schnell zu verarbeiten. Die Komplexität der neuronalen Netze erfordert eine präzise und schnelle Abbildung in die physische Hardware.
Ein Echo State Network benötigt eine bestimmte Konnektivität, die die Hardware-Architektur direkt adressieren muss. Die Fähigkeit der Hardware, diese spezifische Konnektivität effizient abzubilden, ist für die korrekte Modellberechnung notwendig.
Die Nutzung von RDF als Metadatenmodell erfordert eine entsprechende Unterstützung durch die zugrundeliegende Hardware, um den Datenaustausch zu beschleunigen und die Rechenlast zu minimieren.

Kommentare 0