硬體效能如何演進,而運算資源又是如何構成基礎的?
「硬體效能的進步不僅是數字的跳動,更是計算能力的革命。」
在探討如何有效執行大型語言模型時,選擇本地端機運算資源最佳化還是雲端解決方案模型執行比較,是開發者與使用者面臨的核心抉擇。這篇文章將針對本地 LLM 硬體加速實現與雲端資源的效率進行深度分析,幫助讀者掌握如何根據需求選擇最合適的執行環境。透過理解硬體效能的演進與資料儲存的特性,我們可以更精準地規劃運算資源。
硬體效能如何演進,而運算資源又是如何構成基礎的? 在實驗室中調整引數時,我們時常會感嘆運算能力的飛速提升。回溯計算技術的發展史,從 1986 年到 2003 年,硬體效能的年增長率超過了 50%,這段時期的技術突破為平板電腦與行動裝置等新型運算裝置的出現奠定了基礎。這種持續性的增長,也為今日本地端機運算資源最佳化提供了強大的硬體基礎,讓複雜的演算法得以在較小的裝置上執行。
隨著運算需求的增加,硬體架構也必須不斷演進以應對模型規模。過去的硬體提升主要集中在處理單純的指令集,而現代的運算則需要更強大的並行處理能力。這種從傳統運算到現代 AI 加速的轉變,直接決定了模型在本地端執行的速度與效率。
當我們談論雲端解決方案模型執行比較時,無法脫離對底層硬體能力的理解。硬體效能的穩定提升,使得我們能夠在更短的時間內處理更龐大的資料,這對於需要即時反應的語言模型至關重要。這種技術演進的動能,正是推動 AI 應用普及化的關鍵力量。
然而,若單純追求極高的運算算力而忽略了記憶體頻寬的限制,則無法獲得預期的效能提升。
資料儲存架構會如何影響模型的執行?
在深夜昏暗的機房裡,我聽著伺服器運轉的低鳴聲,正透過螢幕觀察著本地端與雲端效能對比所帶來的讀取延遲。 當我站在昏暗的機房中央,聽著伺服器運轉的嗡鳴聲,心中正衡量著本地端與雲端效能對比對資料讀取速度的影響。
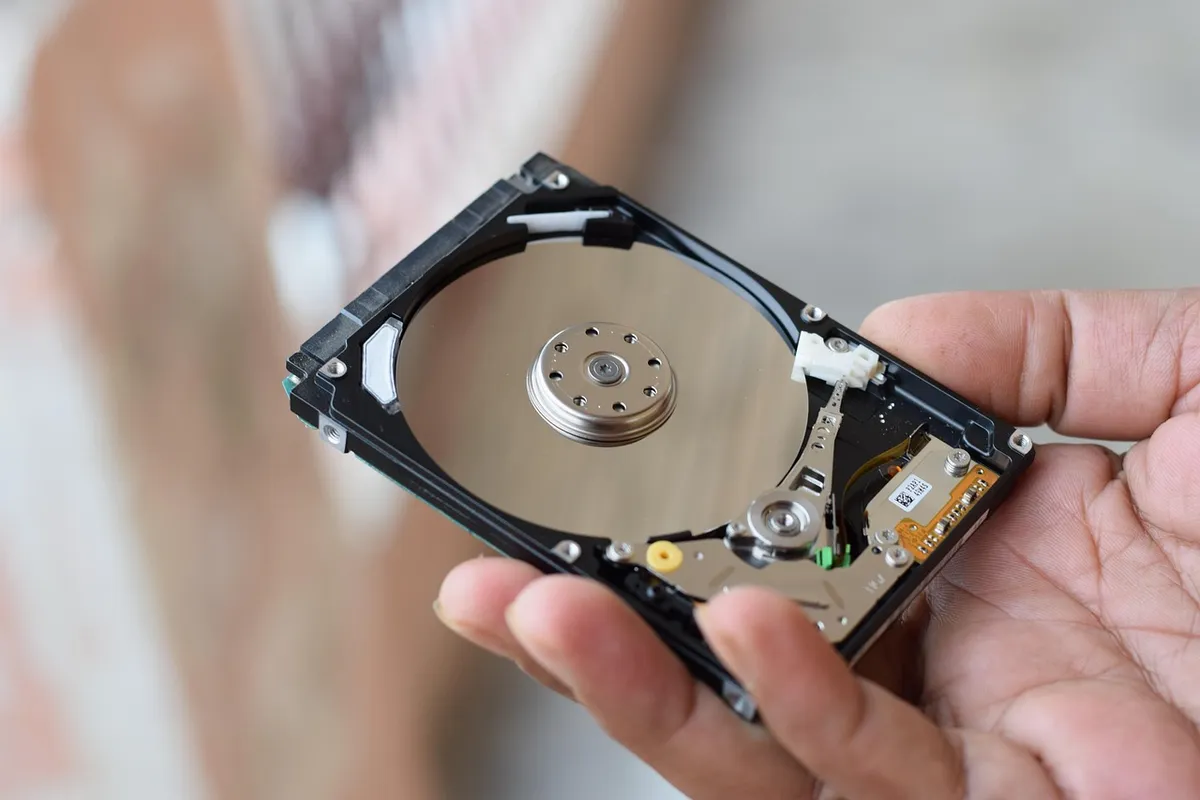
在機房整理伺服器時,觀察著琳瑯滿目的儲存裝置,不難發現資料管理的重要性。根據 2007 年的資料顯示,全球儲存的資料中有將近 94% 是以數位形式存在的,其中 52% 儲存在硬碟上,28% 儲存在光學裝置中,另外 11% 則儲存在數位磁帶中。這些儲存技術的比例分佈,反映了當時資料處理與存取效率的技術現況。
對於本地 LLM 硬體加速實現而言,資料的讀取速度往往是效能的瓶頸。如果儲存介面的速度無法跟上處理器的運算速度,模型在執行推理時就會出現嚴重的延遲。因此,選擇適合的儲存介面與路徑,是最佳化本地執行效率的重要一環。
在進行雲端解決方案模型執行比較時,資料的傳輸效率同樣是核心議題。模型權重與大型語料庫的讀取,需要極高的頻寬與低延遲的儲存架構。理解這些基礎的儲存特性,能讓我們在設計系統時,更有效地配置硬體與雲端資源的比例。
不過,在處理極大規模的資料集時,若儲存介面的讀取速度低於模型需求,則會產生嚴重的 I/O 瓶頸。
建立高效的本地執行工作流程
在實驗室桌面上擺放著各種測試用的顯示卡與處理器,我們需要建立一套標準化的測試流程。為了達成本地端機運算資源最佳化,必須針對不同的模型規模與硬體規格進行精確的配置。以下是建立高效執行流程的三個關鍵步驟:
- 資源評估與硬體匹配:首先需要根據模型引數規模,計算所需的記憶體容量與運算力,選擇具備足夠頻寬的硬體。 2. 軟體框架最佳化:安裝與硬體高度相容的加速庫,利用特定的軟體技術來提升張量運算的效率。 3. 壓力測試與穩定性檢查:在模擬高負載環境下執行模型,確保硬體在長時間運作下不會因為過熱或電力供應不穩而失效。
完成這些步驟後,必須進行最終的效能檢查。透過量化指標來觀察回應速度與吞吐量,確保配置符合預期。我曾嘗試在不同的硬體組合下進行測試,發現最佳化過程中的細微調整往往能帶來顯著的效能差異。
- 評估硬體規格以選擇合適的模型參數規模。
- 配置優化的執行環境與驅動程式。
- 進行基準測試以調整參數達到最佳效率。
本地與雲端的效能對比分析
當我們將實驗室的硬體裝置與雲端伺服器進行對照時,效率的差異便會顯現出來。為了更直觀地呈現兩者的差異,我們可以使用下表進行初步的特性對比。
| 特性指標 | 本地 LLM 硬體加速實現 | 雲端解決方案模型執行比較 | | :---量化] | :---| :---| | 延遲控制 | 具備高度的即時性與隱私性 | 取決於網路連線品質與伺服器負載 | | 擴充彈性 | 受限於實體硬體的物理極限 | 可根據需求隨時調整運算規模 |
透過這份對比,我們可以發現,本地端與雲端各有其優勢與限制。在處理對隱私極度敏感的任務時,本地部署具有天然的優勢;而在需要處理極大規模、突發性運算需求時,雲端資源的彈性則更具吸引力。
這種對比也引發了我們對於模型部署策略的思考。在進行本地部署大型語言模型優勢分析時,我們必須考量到硬體的長期維護成本與電力消耗。而雲端服務則需要權衡服務商的定價策略與資料安全風險。
但若任務涉及極高頻率的即時運算需求,本地硬體的擴充性限制可能會成為效能瓶頸。
解決模型執行的瓶頸問題
在處理突發性的運算錯誤時,我們必須冷靜地找出問題的核心。當模型執行效率低於預期時,通常是因為資源分配不均或硬體瓶頸所致。針對這些問題,我們需要從硬體架構與軟體演算法兩個層面同時著手。
對於追求極致效能的開發者來說,瞭解底層的計算邏輯至關重要。例如,某些神經網路結構具有稀疏連線的特性,這在特定的硬體加速下可以大幅提升運算效率。這種對技術細節的掌握,是實現高效執行的前提。
在評估雲端服務型 LLM 執行成本分析時,我們也必須考慮到這些底層技術如何轉化為實際的成本支出。當我們在尋求本地部署大型語言模型優勢時,不僅要看效能,更要看如何將這些技術轉化為可持續的運算環境。
然而,若硬體資源已達物理極限,僅靠軟體層面的優化將難以解決效能不足的問題。
相關文章

評論 0