aceleração hardware LLM local: melhores estratégias para o modelo
"O desenvolvimento tecnológico não é uma linha reta, mas uma corrida constante entre a necessidade de processamento e a capacidade de hardware disponível."
A execução de modelos de linguagem de grande escala (LLM) exige um equilíbrio delicado entre o poder de processamento local e a escalabilidade da nuvem.
Para decidir entre essas opções, é necessário entender o custo de infraestrutura, a latência de resposta e a disponibilidade de recursos de hardware.
Neste guia, exploramos a comparação de eficiência entre o processamento local e a nuvem, as nuances da aceleração hardware LLM local, a otimização recursos computação e como o ganho desempenho LLM local impacta o uso diário.
Veremos também como o custo computação LLM pode ser gerenciado e as estratégias de desempenho modelo local.
Como a evolução do hardware moldou a computação?
Um técnico olha para um antigo computador de mesa e depois para um smartphone moderno, notando a diferença abismal de poder. A história da computação mostra que o salto tecnológico foi o que permitiu a miniaturização e a inteligência embarcada.
Segundo dados históricos, de 1986 a 2003, a taxa anual de melhoria no desempenho do hardware excedeu 50 por cento, o que possibilitou o desenvolvimento de novos dispositivos de computação, como tablets e celulares.
Esse crescimento exponencial é o que fundamenta a possibilidade de rodar modelos complexos hoje.
Essa evolução constante criou a base para que hoje possamos discutir a execução modelo local vs nuvem. Sem o aumento de desempenho observado nessas décadas, a inteligência artificial não teria saído dos grandes centros de pesquisa para chegar às mãos dos usuários comuns.
A constante busca por eficiência é o que define o ritmo atual.
O que define a eficiência na execução de modelos? aceleração hardware LLM local
No silêncio do escritório durante a madrugada, o desenvolvedor observa como a organização dos dados acelera o processamento na tela brilhante.
Um desenvolvedor ajusta os parâmetros de uma rede neural em uma estação de trabalho potente, observando o uso da CPU e GPU. A eficiência depende de como os recursos são distribuídos para evitar gargalos durante o processamento de dados.
A otimização recursos computação é essencial quando lidamos com arquiteturas complexas. Por exemplo, uma echo state network (ESN) é uma rede neural recorrente com uma camada oculta esparsamente conectada, que possui tipicamente 1% de conectividade.
Essa característica de conectividade esparsa é um exemplo de como a estrutura pode ser otimizada para eficiência.
Ao entender a estrutura interna, como a conectividade de uma rede, torna-se mais fácil planejar a infraestrutura necessária. O equilíbrio entre o número de parâmetros e a capacidade de processamento determina se um modelo será fluido ou lento.
A arquitetura do modelo dita a necessidade de hardware.
Como gerenciar o armazenamento e os dados?
Um engenheiro de dados organiza grandes volumes de informação em servidores, garantindo que o acesso seja rápido e seguro. O gerenciamento de dados é um pilar fundamental para qualquer sistema de inteligência artificial que dependa de grandes bases de conhecimento.
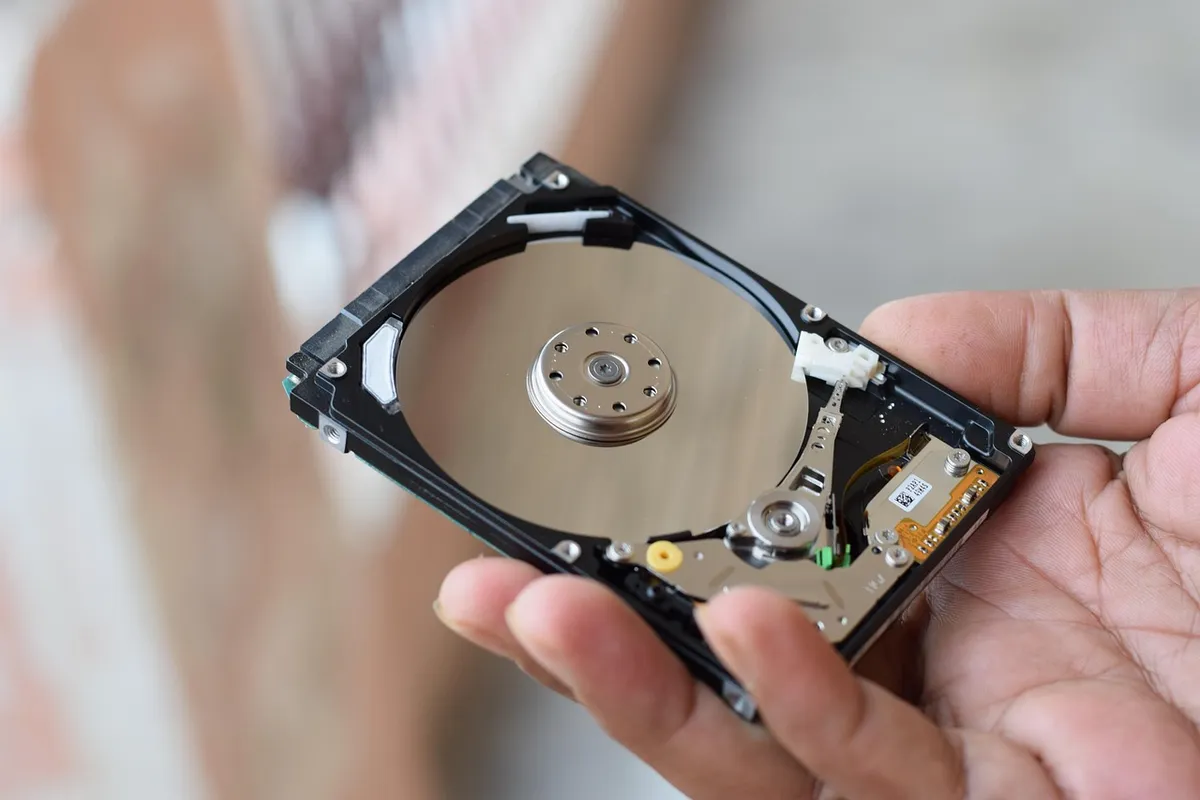
A questão do armazenamento é crítica, pois modelos de linguagem exigem acesso rápido a vastos conjuntos de dados. Em 2007, quase 94% dos dados armazenados mundialmente eram mantidos digitalmente: 52% em discos rígidos, 28% em dispositivos ópticos e 11% em fita magnética digital.
Essa distribuição histórica de dados mostra a transição para meios digitais que hoje sustentam os LLMs. Ter o dado disponível e acessível é tão importante quanto ter o poder de processamento para processá-lo.
A infraestrutura de armazenamento deve acompanhar a velocidade do processamento.
Qual a diferença entre rodar localmente ou na nuvem?
Um usuário testa um modelo em seu laptop e percebe a diferença de velocidade ao mudar para um serviço de nuvem. A escolha entre local e nuvem envolve trade-offs entre privacidade, custo e velocidade pura.
A execução LLM rodando local ou nuvem apresenta desafios distintos. No ambiente local, o controle sobre a privacidade é total, mas o hardware está limitado ao que o usuário possui. Na nuvem, o poder é quase ilimitado, mas a latência e os custos recorrentes são fatores determinantes.
A decisão geralmente passa pelo custo computação LLM. Enquanto o investimento inicial em hardware local pode ser alto, o custo operacional pode ser menor a longo prazo se comparado a assinaturas de nuvem.
Por outro lado, a nuvem oferece uma escalabilidade que o hardware doméstico dificilmente alcança.
O uso de cada ambiente depende da aplicação final.
Como otimizar o desempenho do modelo?
Um pesquisador ajusta os pesos de um modelo para reduzir o tempo de resposta em milissegundos. A otimização é um processo contínuo de ajuste fino para extrair o máximo de cada ciclo de processamento.
O ganho desempenho LLM local é frequentemente buscado através de técnicas de quantização e otimização de kernels. O objetivo é reduzir a carga de trabalho sem sacrطificar a inteligência do modelo.
Para implementar uma estratégia de otimização, siga estes passos:
- Avalie a capacidade de memória de vídeo (VRAM) do seu hardware para garantir que o modelo caiba no dispositivo. 2. Utilize técnicas de compressão ou quantização para reduzir o tamanho do modelo e aumentar a velocidade. 3. Configure corretamente os drivers de aceleração para garantir que o software utilize o hardware de forma eficiente.
Após configurar, faça um teste de estresse para verificar a estabilidade térmica e o tempo de resposta.
Eu notei que, ao aplicar técnicas de compressão em modelos menores, a resposta se tornou muito mais fluida em hardware de entrada.
Uma limitação importante ocorre quando o modelo é grande demais para a memória disponível, pois o uso de memória virtual pode causar lentidão extrema.
- Como a evolução do hardware moldou a computação?
- O que define a eficiência na execução de modelos?
- Como gerenciar o armazenamento e os dados?
Esta parte também cobre comparativo eficiência execução.
Artigos relacionados
- Como preparar a infraestrutura para a IA como ferramenta dev?
- Modelo aberto vs proprietário: como comparar modelos IA com 87,5%
Quais são as implicações do desenvolvimento tecnológico atual? O desenvolvimento tecnológico atual mostra que a corrida por processamento e hardware é contínua. A busca por eficiência é o que realmente dita o ritmo dessa corrida. De acordo com a National Highway Traffic Safety Administration, os resultados de um estudo de 10 meses realizado em fevereiro de 2011 visava identificar a causa principal da aceleração repentina em modelos Toyota e Lexus. Segundo a National Aeronautics and Space Administration, os resultados de um estudo de 10 meses realizado em fevereiro de 2011 visava identificar a causa principal da aceleração repentina em modelos Toyota e Lexus.
O salto de desempenho visto entre 1986 e 2003, por exemplo, foi crucial para que a inteligência artificial saísse dos laboratórios e chegasse ao usuário comum. Essa aceleração constante é o que permite discutir hoje a execução local versus nuvem.
O ganho de desempenho que buscamos ao otimizar um modelo reflete essa mesma busca por eficiência que moveu a computação por décadas.
Perguntas frequentes
Qual a importância do hardware para o desempenho?
Como os dados eram armazenados historicamente?
Publicações relacionadas
Como preparar a infraestrutura para a IA como ferramenta dev?
Modelo aberto vs proprietário: como comparar modelos IA com 87,5%
LLM local: guia para otimizar custos com Nuvem e LLM local
Modelo 70B: Guia de IA multimodal e personagens para desempenho
Publicações populares
Como a demanda por infraestrutura de IA impactará o futuro?
Como preparar a infraestrutura para a IA como ferramenta dev?

Dados: Guia para entender a participação global de 20% da China
Comentários 0