LLM local: guia para otimizar custos com Nuvem e LLM local
A integração entre infraestrutura de nuvem e modelos de linguagem de grande escala (LLM) locais representa o novo equilíbrio de poder para empresas que buscam eficiência e segurança.
O uso de infraestrutura híbrida permite equilibrar o poder de processamento massivo da nuvem com a privacidade de execução local. Este guia explora como gerenciar recursos de GPU nuvem e execução local LLM para otimizar o desempenho e a segurança de dados.
* Equilíbrio entre processamento em larga escala e privacidade local. * Otimização de custos através de estratégias de processamento distribuído. * Segurança cibernética como pilar para a continuidade operacional.
Como a infraestrutura híbrida IA funciona na prática?
Ao amanhecer, o administrador desliza os dedos pelo teclado no escritório, equilibrando o tráfego entre a nuvem e o servidor local.
Um administrador de sistemas ajusta o tráfego de dados entre um servidor local e um provedor de nuvem para evitar latência. A infraestrutura híbrida IA utiliza a nuvem para tarefas de treinamento pesado e o ambiente local para inferência sensível.
A implementação de uma estratégia híbrida IA exige que as empresas decidam quais modelos residirão em servidores próprios e quais utilizarão recursos externos. Segundo dados de mercado, os serviços de nuvem abrangem 97% do mercado global de serviços de nuvem.
Essa escala permite que empresas de diversos tamanhos acessem capacidades de processamento que seriam proibitivas em hardware local.
Ao implementar a infraestrutura híbrida IA, o objetivo é mover a carga de trabalho para onde ela é mais eficiente. Em cenários de alta demanda, o escalonamento para a nuvem resolve gargalos de hardware, enquanto o processamento local mantém a soberania sobre dados críticos.
Por que considerar o deploy LLM nuvem local para segurança? Nuvem e LLM local
Um técnico de segurança verifica os logs de acesso em um data center para garantir que nenhum dado sensível vazou para a rede externa. O deploy LLM nuvem local foca em manter modelos de linguagem rodando em ambientes controlados para proteger a propriedade intelectual.
A segurança é um fator determinante na escolha do modelo de implantação. Em 2023, 80% das empresas de tecnologia da China e metade das empresas de IA LLM utilizaram a Alibaba Cloud, enquanto nos EUA a dominância pertencia à AWS com uma participação de 31 a 50%.
Essas proporções mostram a dependência de grandes provedores para o desenvolvimento de inteligência artificial.
A estratégia de deploy LLM nuvem local protege contra vulnerabilidades que podem surgir em conexões externas.
Por exemplo, falhas de segurança podem levar à suspensão de parcerias ou interrupções de serviços, como ocorreu quando o Ministério da Indústria e Tecnologia da Informação da China suspendeu uma parceria com a Alibaba Cloud em 22 de dezembro de 2021, devido a falhas no relato de vulnerabilidades de segurança cibernética relacionadas ao bug Log4Shell.
Como a otimização recursos nuvem impacta os custos operacionais?
Um gestor financeiro analisa a fatura mensal de serviços de TI para identificar gastos excessivos com processamento de IA. A otimização recursos nuvem envolve o uso inteligente de instâncias sob demanda versus instâncias reservadas para modelos de linguagem.
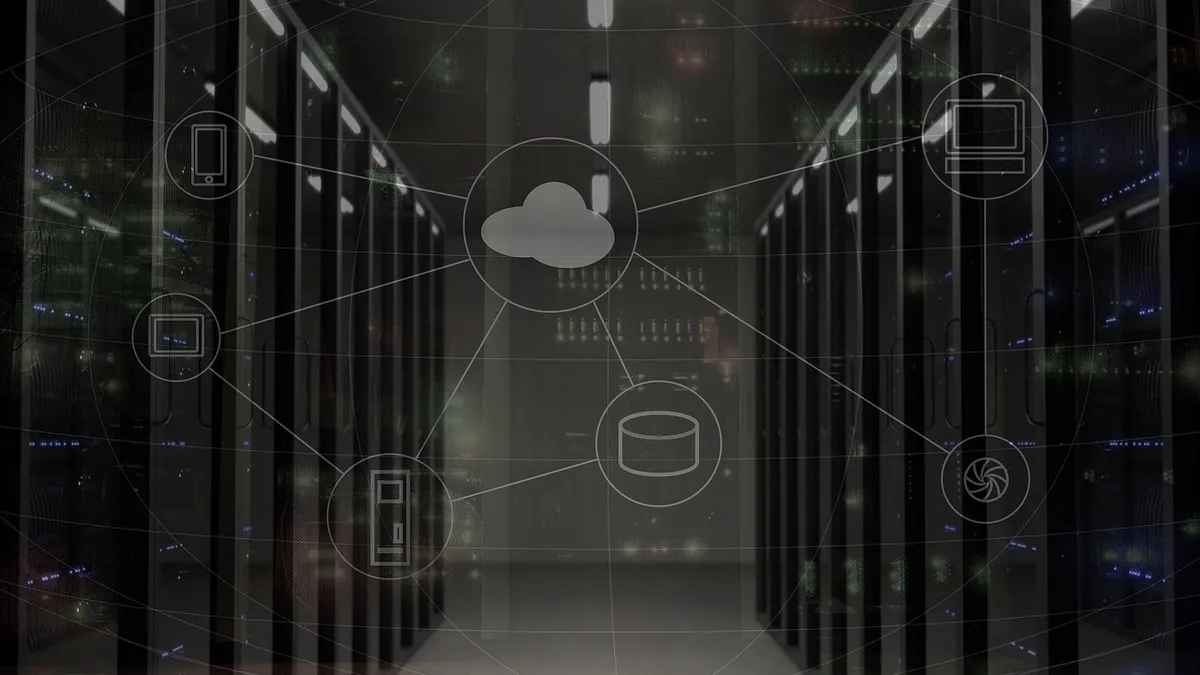
A eficiência financeira é um dos principais motores da adoção de modelos híbridos. Empresas que utilizam armazenamento em nuvem podem reduzir seu consumo de energia em até 70%, tornando-as negócios mais sustentáveis.
Esse tipo de economia é essencial quando se lida com o alto consumo energético dos modelos de linguagem.
A otimização recursos nuvem permite que as empresas não paguem por hardware ocioso. Ao utilizar a nuvem para picos de demanda e o hardware local para cargas de trabalho constantes, o custo total de propriedade é reduzido significativamente.
Qual o papel da execução local LLM na soberania de dados?
Um desenvolvedor configura um servidor com múltiplas GPUs para rodar um modelo de linguagem sem conexão com a internet. A execução local LLM garante que dados proprietários nunca saiam das fronteiras físicas da organização.
A execução local LLM é a resposta para regulamentações rígidas de privacidade. Em setores como jurídico ou médico, a latência e o risco de vazamento de dados impedem o uso de nuvens públicas para certas tarefas.
Ao equilibrar a execução local LLM com a nuvem, as empresas criam uma camada de proteção. Os dados podem ser processados localmente para garantir o sigilo, enquanto apenas metadados ou consultas não sensíveis são enviados para processamento em larga escala na nuvem.
Como organizar a estratégia híbrida IA em três etapas?
Um arquiteto de soluções desenha o fluxo de dados entre o escritório central e a região de nuvem mais próxima. Uma estratégia híbrida IA bem estruturada segue um processo de categorização de carga de trabalho e recursos.
- Classificação de Dados: Identifique quais dados são sensíveis e devem permanecer em execução local LLM e quais podem ser processados na nuvem. 2. Dimensionamento de Hardware: Aloque modelos menores e tarefas de baixa latência para servidores locais, reservando a nuvem para treinamento e processamento massivo. 3. Integração de APIs: Estabeleça túneis seguros para que o ambiente local e a nuvem se comuniquem sem comprometer a segurança cibernética.
Após essas etapas, realize um check de latência e segurança para garantir que o fluxo entre o local e a nuvem não apresente gargalos ou exposições desnecessárias.
Como a infraestrutura híbrida IA lida com a escalabilidade?
Um engenheiro de infraestrutura adiciona novos nós de processamento a um cluster para suportar o aumento de usuários. A escalabilidade é gerenciada movendo cargas de trabalho para a nuvem quando o hardware local atinge o limite.
A escalabilidade é o maior benefício de utilizar a nuvem. Enquanto o hardware local tem limites físicos de expansão, a nuvem oferece recursos praticamente infinitos.
| Cenário de Carga | Abordagem Recomendada | | :--- | :io: | | Pico de demanda súbito | Escalabilidade via nuvem | | Processamento contínuo e privado | Execução local |
Eu observei que a transição entre o hardware local e a nuvem deve ser fluida para não interromper o serviço ao usuário final.
A limitação desta abordagem ocorre quando a conectividade de rede é instável, o que pode impedir a sincronização entre a infraestrutura local e a nuvem.
- Como a infraestrutura híbrida IA funciona na prática?
- Por que considerar o deploy LLM nuvem local para segurança?
- Como a otimização recursos nuvem impacta os custos operacionais?
O tema desta seção é Nuvem e LLM local.
O mesmo tema também se chama Infra híbrida IA.
O mesmo tema também se chama Recursos GPU nuvem.
O mesmo tema também se chama Computação nuvem local.
Artigos relacionados
Perguntas frequentes
Qual a diferença entre o uso de nuvem e local?
Publicações relacionadas
Modelo aberto vs proprietário: como comparar modelos IA com 87,5%
Modelo 70B: Guia de IA multimodal e personagens para desempenho

Dados: Guia para entender a participação global de 20% da China
Hardware Local: Como rodar modelos em apenas 8 GB de VRAM
Publicações populares
Como a demanda por infraestrutura de IA impactará o futuro?
Dados: Guia para entender a participação global de 20% da China
Desenvolvimento Seguro: O Poder dos LLMs Offline em 2025
Comentários 0