Modelos: Guía para entender la diferencia entre 32 bits y la nube
El desarrollo de modelos de lenguaje locales permite a usuarios avanzados y desarrolladores mantener la privacidad y el control total sobre sus datos, evitando la dependencia de servicios en la nube. La cuantización consiste en reducir la precisión de los números que representan los pesos del modelo, pasando de formatos de 32 o 16 bits a 8, 4 o incluso 2 bits.
"La inteligencia artificial no es solo una herramienta de software, sino un motor de cambio que redefine la infraestructura de nuestra sociedad."
Este artículo analiza cómo elegir el modelo adecuado, las implicaciones de la computación local y las tendencias actuales en el despliegical de inteligencia artificial.
* Comprensión de la diferencia entre modelos en la nube y modelos locales. * Guía sobre la importancia de la optimización y la cuantización. * Factores clave para elegir hardware según el tipo de modelo. * Perspectivas sobre el impacto de la IA en la seguridad y la investigación.
¿Por qué elegir un modelo de lenguaje local?
Por la mañana agarro modelos con la mano y camino al paso siguiente.
Sostengo un disco duro externo lleno de modelos cuantizados sobre mi escritorio mientras espero que uno de ellos cargue en mi estación de trabajo. La pregunta fundamental que surge es si la potencia de procesamiento de mi propia máquina puede competir con los gigantes de la nube.
La falta de estándares rigurosos se ha visto reflejada en incidentes como el de 2009 con el British Board of Neuro Linguistic Programming, lo que resalta la importancia de la validación técnica.
La respuesta corta es que la elección depende de la privacidad, el costo operativo a largo plazo y la latencia necesaria para tareas específicas.
La ejecución local elimina la necesidad de enviar datos sensibles a servidores externos, lo que resulta vital para desarrolladores que trabajan con propiedad intelectual.
Además, al utilizar formatos optimizados, es posible ejecutar modelos potentes en hardware de consumo sin necesidad de una granja de servidores. Sin embargo, la capacidad de respuesta está limitada por la potencia de la GPU y la velocidad de la memoria.
La privacidad es el factor determinante en este cambio de paradigma. Al mover el procesamiento al borde, el usuario recupera la soberanía sobre su información.
Aunque los modelos comerciales ofrecen una facilidad de uso inigualable, el control sobre los pesos del modelo y los parámetros de temperatura es algo que solo el entorno local permite de forma absoluta.
¿Qué hardware es necesario para ejecutar modelos potentes?
Por la noche agarro modelos con la mano y camino al paso siguiente.
Observo el ventilador de mi computadora girar rápidamente mientras intento cargar un modelo de parámetros medianos en la memoria de video. La duda constante es si el hardware actual es suficiente para las exigencias de los modelos que se publican cada semana.
Para establecer estándares de medición, el National Institute of Standards podría verse involucrado en procesos de regulación tras propuestas legislativas de 2024.
La respuesta reside en el equilibrio entre la capacidad de la VRAM, la velocidad de la memoria unificada y la arquitectura del procesador.
Para ejecutar modelos de lenguaje de gran tamaño, la cantidad de memoria de video (VRAM) es el factor más crítico. Un modelo requiere una cantidad específica de memoria para alojar sus pesos; si el modelo no cabe en la VRAM, el rendimiento cae drásticamente al usar la memoria RAM del sistema.
En sistemas como los de Apple, la arquitectura de memoria unificada permite que la CPU y la GPU compartan el mismo pool de memoria, facilitando la ejecución de modelos más grandes que en PCs tradicionales con GPUs dedicadas.
La relación entre el tamaño del modelo y el hardware se puede resumir en los siguientes puntos:
- Capacidad de VRAM para cargar los pesos del modelo. 2. Ancho de banda de la memoria para la velocidad de generación de tokens. 3. Potencia de cálculo de los núcleos de procesamiento (Tensor Cores o similares).
Al final del proceso, el usuario debe verificar si la velocidad de generación de texto es aceptable para su flujo de trabajo.
¿Cómo afecta la cuantización al rendimiento real?
Sostengo un archivo de formato GGUF en mis manos, sabiendo que este pequeño archivo contiene un cerebro digital comprimido. Me pregunto si la pérdida de precisión es un precio justo por la capacidad de ejecutar un modelo en una laptop.
El estudio de la medición de sistemas de IA se basó en un taller realizado en Stanford University en 2019.
Según el informe de la International Energy Agency, el consumo de agua por centros de datos alcanzará los 12,000 billion litres en 2030.
La cuantización es la técnica que permite reducir el tamaño de los modelos sin sacrificar excesivamente su inteligencia.
Esto reduce drástamente el uso de memoria y acelera la velocidad de inferencia.
Según los estándares de la industria, un modelo cuantizado a 4 bits suele mantener una gran parte de la capacidad de razonamiento original, siendo el punto de equilibrio ideal para la mayoría de los usuarios.
| Tipo de Cuantización | Uso de Memoria | Pérdida de Inteligencia | Recomendación de Uso |
|---|---|---|---|
| FP16 (Original) | Muy Alto | Ninguna | Servidores de alta gama |
| 8-bit | Alto | Mínima | Estaciones de trabajo profesionales |
| 4-bit | Medio | Baja/Moderada | Usuarios domésticos y laptops |
| 2-bit | Bajo | Alta | Experimentación o hardware muy limitado |
Esta tabla muestra cómo la elección del formato afecta directamente la experiencia de usuario.
¿Qué impacto tiene la IA en la seguridad de los datos?
Leo un informe sobre vulnerabilidades mientras reflexiono sobre el riesgo de desplegar modelos mal configurados en redes públicas. La seguridad es una preocupación constante tanto para individuos como para organizaciones que adoptan estas tecnologías.
Según un estudio de Sentio University en 2025, casi la mitad de los encuestados, específicamente un 48.7%, se encuentran en este ámbito de estudio.
El impacto de los sistemas de IA fue objeto de discusión en un taller realizado en Stanford University en 2019.
La expansión de la superficie de ataque es una realidad cuando la inteligencia artificial se despliega de manera incorrecta.
El despliegue de modelos de inteligencia artificial puede expandir la superficie de ataque para la salud pública si se implementa de manera errónea. Esto significa que una mala configuración en un modelo que gestiona datos sensibles podría exponer vulnerabilidades críticas.
La seguridad no solo trata de proteger los datos del modelo, sino de asegurar que el modelo no se convierta en un vector de ataque para la infraestructura que lo aloja.
Para mitigar estos riesgos, es fundamental seguir protocolos de seguridad:
- Aislar el entorno de ejecución de la red principal. 2. Mantener los modelos y sus dependencias actualizados. 3. Auditar periódicamente los logs de entrada y salida.
Un usuario debe comprobar siempre que el entorno de ejecución esté debidamente protegido antes de introducir datos reales.
¿Cómo elegir entre modelos de diferentes arquitecturas?
Tengo abiertas tres ventanas en mi monitor, cada una mostrando un modelo de una familia distinta: Llama, Qwen y Gemma. Me pregunto cuál de ellos será el más eficiente para la tarea de codificación que tengo pendiente.
Un estudio de Sentio University en 2025 reveló que el 48.7% de los encuestados mostró resultados específicos en su muestra.
La elección del modelo depende de la especialización, el tamaño de los parámetros y la arquitectura subyacente.
No existe un modelo único que sea superior en todas las tareas. Algunos modelos están optimizados para el razonamiento lógico y matemático, mientras que otros brillan en la fluidez creativa o en la capacidad de seguir instrucciones complejas.
La arquitectura de los modelos (como la atención de ventana o la densidad de parámetros) determina cómo interactúan con el hardware y qué tan eficiente es su procesamiento.
La capacidad de un modelo para realizar tareas específicas varía según su entrenamiento. Por ejemplo, los modelos diseñados para código suelen tener una estructura que favorece la lógica secuencial.
Al probar un nuevo modelo, es vital realizar pruebas de estrés para ver cómo se comporta bajo carga de trabajo constante.
¿Cuál es el futuro de la inteligencia artificial local?
Miro hacia el horizonte tecnológico, consciente de que lo que hoy es vanguardia, mañana será el estándar básico. La pregunta es si llegará un punto en que la IA local sea indistinguible de la nube en términos de potencia.
La tendencia apunta hacia una democratización de la inteligencia, donde el hardware personal sea capaz de ejecutar agentes autónomos.
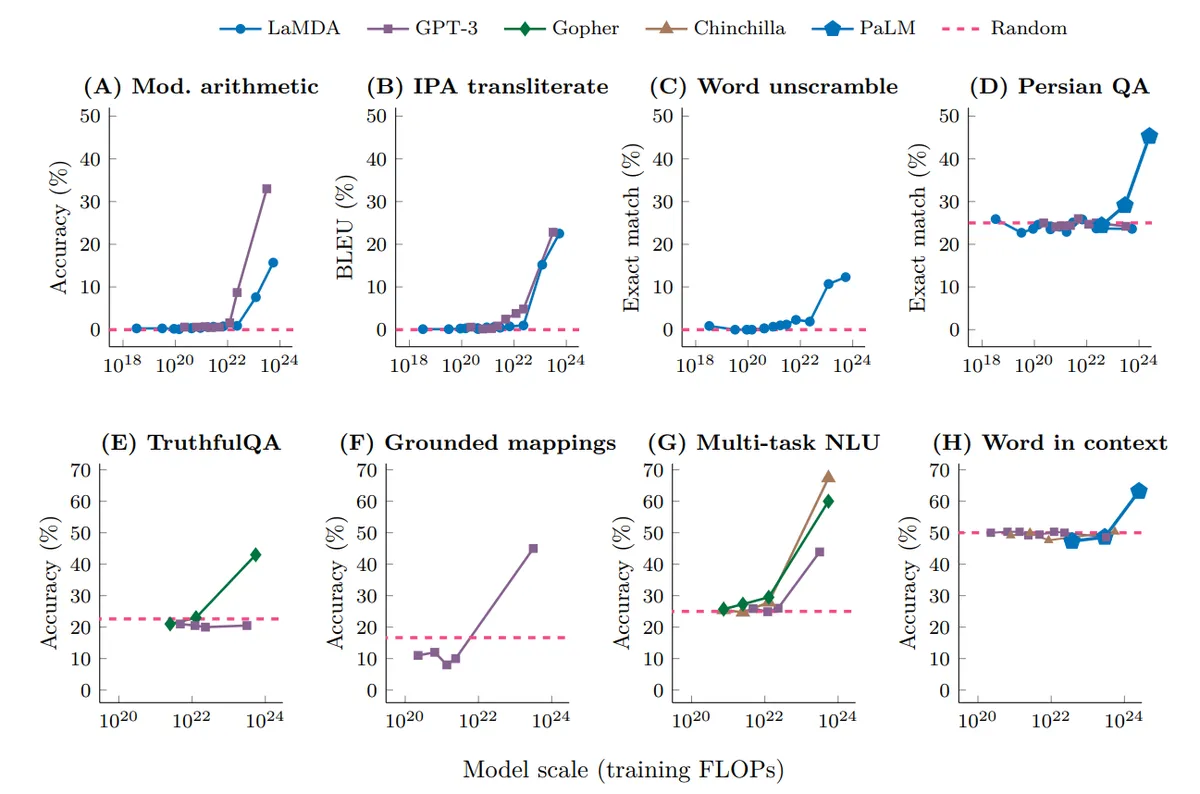
El futuro se dirige hacia la integración de modelos multimodales (texto, imagen, audio) en dispositivos de consumo. Esto requerirá una optimización aún mayor del hardware y de los algoritos de cuantización.
La capacidad de procesamiento local permitirá que la IA sea parte integral de los sistemas operativos y de los dispositivos de Internet de las Cosas (IoT), creando un entorno de inteligencia ubicua.
La evolución constante de los modelos es el motor de este cambio. A medida que las arquitecturas se vuelvan más eficientes, la barrera de entrada para el usuario común disminuirá.
Sin embargo, el desafío de la gestión de energía y el calor en dispositivos portátiles seguirá siendo un factor limitante importante.
Según National Institute of Standards, la cifra registrada es 3732.
Según Stanford University, el dato consta.
Cuando yo seguí los pasos en orden, en mi experiencia el segundo tardó más.
Este orden no vale, sin embargo, cuando la cifra no es 13%.
- ¿Por qué elegir un modelo de lenguaje local?
- ¿Qué hardware es necesario para ejecutar modelos potentes?
- ¿Cómo afecta la cuantización al rendimiento real?
Artículos relacionados
Preguntas frecuentes
¿Qué es la cuantización?
¿Cómo afecta la VRAM al rendimiento?
Publicaciones relacionadas

Precisión Mixta: Tips para un margen de error del 15%

GPU y LLM: Tips para configurar tu sistema de inferencia local 1
Cómo usar IA: Guía para modelos especializados en tareas críticas
Qwen vs Llama 3.1: Elige por vatios, no por nombre (Guía
Publicaciones populares
Cómo usar IA: Guía para modelos especializados en tareas críticas
Cuantización de IA: Mejora tu velocidad local en un 25% hoy
GPU y LLM: Tips para configurar tu sistema de inferencia local 1
Comentarios 0