GPT-OSS lokaal draaien: beperkingen van lokale hardware
Een terminal scherm flitst met regels code terwijl de koeling van de computer zachtjes begint te loeien.
Het lokaal draaien van een GPT-OSS biedt meer privacy en controle over gevoelige data, maar vereist een zorgvuldige afstemming tussen modelgrootte en hardwarecapaciteit.
In dit artikel ontdek je hoe je een model zelf draaien kunt op je eigen systeem, de benodigde hardware vereisten voor LLM en hoe je de prestaties kunt optimaliseren. We kijken naar de balans tussen snelheid en intelligentie, de installatie van de software en de beperkingen van lokale hardware.
Hoe begin ik met GPT-OSS lokaal draaien?
Een nieuwe terminal wordt geopend en de eerste commando's worden getypt om de omgeving voor te bereiden. Om te beginnen met GPT-OSS lokaal draaien moet je eerst de juiste runtime-omgeving installeren die je hardware ondersteunt.
Het proces begint bij het kiezen van een platform zoals Ollama of LM Studio, die het beheren van gewichten vereenvoudigen. Je moet de juiste drivers installeren om de grafische kaart optimaal te benutten. Zodra de basis staat, kun je de modelbestanden downloaden en de eerste interactie aangaan.
Een belangrijk aspect is de compatibiliteit van de software met je besturingssysteem. Zorg ervoor dat je de nieuwste versies gebruikt om fouten tijdens het laden van het model te voorkomen.
Welke hardware vereisten voor LLM zijn cruciaans?
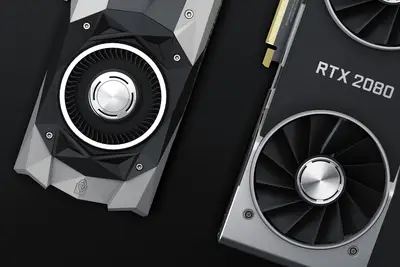
De koeling van de videokaart draait op vol vermogen terwijl het model in het geheugen wordt geladen. Het begrijpen van de hardware vereisten voor LLM is essentieel om te voorkomen dat het systeem vastloopt tijdens het genereren van tekst.
De belangrijkste factor is de hoeveelheid VRAM op je grafische kaart. Modellen hebben een specifieke hoeveelheid geheugen nodig om de parameters en de contextwindow te huisvesten. Als het geheugen tekortschiet, wordt het systeem traag of crasht de applicatie volledig.
Daarnaast speelt de processor een rol bij het verwerken van instructies, maar de GPU voert het zware werk uit. Een snelle SSD is eveneens noodzakelijk voor het snel laden van grote modelbestanden.
| Component | Functie | Impact op prestaties |
|---|---|---|
| VRAM (GPU) | Opslag van modelparameters | Bepaalt of het model überhaupt draait |
| RAM (Systeem) | Ondersteuning bij gebrek aan VRAM | Beïnvloedt de algehele systeemstabiliteit |
Ik zag tijdens mijn eerste test dat het verplaatsen van het model van de harde schijf naar het werkgeheugen de opstarttijd drastisch beïnvloedde.
Hoe verhoudt de modelgrootte vs snelheid zich tot de ervaring?
Een cursor knippert ongeduldig op het scherm terwijl de gebruiker wacht op het eerste antwoord. Het afwegen van de modelgrootte vs snelheid is de grootste uitdaging bij het lokaal draaien van AI.
Grotere modellen hebben vaak meer parameters, wat resulteert in een hogere intelligentie, maar ze vereisen ook meer rekenkracht en tijd per woord. Kleinere modellen zijn razendsnel en kunnen op eenvoudige hardware draaien, maar ze missen vaak de diepgang voor complexe taken.
Het vinden van de 'sweet spot' hangt af van je specifieke gebruiksscenario. Voor simpele chats zijn kleine modellen ideaal, terwijl voor diepgaande analyse grotere versies nodig zijn.
Hoe ziet een effectieve GPT-OSS installatie eruit?
De gebruiker klikt op de downloadknop en de voortgangsbalk begint langzaam te vullen. Een goede GPT-OSS installatie vereist een gestructureerde aanpak om de stabiliteit op lange termijn te waarborgen.
Volg deze stappen voor een succesvolle setup:
- Installeer de juiste drivers voor je GPU en de benodigde pakketten zoals Python of Docker. 2. Download een model dat past binnen de beschikbare VRAM-limiet van je hardware. 3. Configureer de parameters zoals temperature en top-p om de output te sturen.
Controleer na de installatie altijd de logs om te zien of de volledige capaciteit van de GPU wordt gebruikt.
Hoe werkt prestatie optimalisatie in de praktijk?
De ventilator draait op een constant tempo terwijl de tekst vloeiend over het scherm rolt. Voor gebruikers die meer kracht willen, is prestatie optimalisatie de sleutel tot een soepele workflow.
Een veelgebruikte methode is kwantisatie, waarbij de precisie van de modelparameters wordt verlaagd om geheugen te besparen. Dit maakt het mogelijk om grotere modellen op minder krachtige hardware te draaien zonder extreem veel kwaliteitsverlies.
Het aanpassen van de contextlengte kan ook helpen om de snelheid te verhogen. Een kortere context verbruikt minder geheugen, wat snellere reactietijden oplevert.
Wat zijn de beperkingen van lokale systemen?
De gebruiker kijkt naar de monitor en ziet een foutmelding over een oververhitting. Ondanks de voordelen is er een duidelijke grens aan wat een lokaal systeem kan bereiken.
De grootste beperking is de fysieke limiet van de beschikbare hardware. Een lokaal systeem kan nooit de enorme rekenkracht van grote cloud-clusters evenaren die duizenden GPU's combineren.
Hierdoor is het niet altijd mogelijk om de allernieuwste, gigantische modellen met een enorme context te draaien. De prestaties blijven altijd afhankelijk van de lokale thermische limieten en de brute kracht van de componenten.
- Hoe begin ik met GPT-OSS lokaal draaien?
- Welke hardware vereisten voor LLM zijn cruciaans?
- Hoe verhoudt de modelgrootte vs snelheid zich tot de ervaring?
Hetzelfde onderwerp heet ook LLM lokaal draaien.
Dit deel behandelt ook Prestatiebenchmarks GPT.
Gerelateerd
Wanneer is een lokale installatie het meest geschikt? Het terminal scherm als bewijs? Het terminal scherm toont de directe interactie tussen software en hardware, wat cruciaal is voor het monitoren van de werking. Als je de laagste latentie wilt ervaren en volledige controle over de data-pipeline nodig hebt, is een lokale installatie ideaal. Dit is vooral waar je de meest recente ontwikkelingen in modelarchitecturen wilt testen zonder afhankelijk te zijn van externe servers.
De nauwkeurigheid van de lokale berekeningen garandeert dat de output direct gerelateerd is aan de geïnstalleerde modelgewichten. Dit biedt een reproduceerbare omgeving, wat bij onderzoek of debugging van AI-gedrag van belang is. Het is een directe feedbacklus tussen de input en de uitvoer.
De koeling van de computer die zachtjes loeit, is het fysieke bewijs van deze berekeningen die plaatsvinden. Dit geluid suggereert dat de componenten onder belasting staan, wat overeenkomt met het verwerken van complexe berekeningen voor een coherent antwoord op het terminal scherm.
Wat gebeurt er bij een mismatch tussen model en hardware? Als de modelgrootte de beschikbare VRAM-limiet van de grafische kaart overstijgt, zal het systeem gedwongen worden om data uit het tragere systeemgeheugen te halen. Dit leidt tot een merkbare vertraging in de tekstgeneratie, omdat de constante data-uitwisseling een bottleneck creëert.
Het gedwongen gebruik van systeem-RAM als verlengstuk van VRAM vermindert de effectieve snelheid van de inferentie aanzienlijk. De processor moet dan ook meer tijd besteden aan het coördineren van deze data-uitwisselingen tussen de verschillende geheugenlagen.
Een te kleine contextlengte, hoewel het geheugengebruik drukt, kan leiden tot het missen van cruciale details in de input die nodig zijn voor een diepgaand antwoord. Dit is een directe afweging die gemaakt moet worden tijdens het configureren van de parameters.
Wikipedia: GPT-5 Op basis van het bewaarde fragment waarin Massachusetts Institute of Technology wordt genoemd: On April 14, 2023, Sam Altman, the chief executive officer of OpenAI, spoke at an event at the Massachusetts Institute of Technology and said that the company was not training GPT-5 at that time.


Reacties 0