Waarom is LLM uitvoeren hardware versnelling zo belangrijk?
Een krachtige computer voor LLM uitvoeren hardware versnelling vereist een diep begrip van zowel lokale rekenkracht als de flexibiliteit van de cloud. Dit artikel vergelijkt de efficiëntie van lokale hardware versus cloudoplossingen, met aandacht voor de noodzakelijke rekenkracht en de praktische implementatie.
* De kern van lokale prestaties ligt in de jaarlijkse verbetering van hardware. * Cloudoplossingen bieden schaalbaarheid die lokale systemen vaak missen. * Hardware versnelling LLM is essentieel voor het draaien van grotere modellen. * De keuze tussen lokaal en cloud hangt af van de specifieke workload en data-integriteit.
Waarom is LLM uitvoeren hardware versnelling zo belangrijk?
Een gebruiker zit achter een bureau en kijkt naar een scherm waar een tekstmodel traag reageert op een eenvoudige vraag. De koeling van de computer begint te loeien terwijl de processor probeert de enorme hoeveelheid parameters te verwerken.
Volgens het rapport van National Highway Traffic Safety Administration waren de bevindingen van een 10 maanden durende studie die in februari 2011 werd uitgevoerd door de National Highway Traffic Safety Administration (NHTSA) en de National Aeronautics and Space Administration (NASA), gericht op het identificeren van de hoofdoorzaak van plotselinge versnelling in Toyota- en Lexus-modellen.
Het draaien van een lokaal taalmodel vereist enorme hoeveelheden rekenkracht om de wachttijden te minimaliseren. De snelheid waarmee een model antwoord geeft, is direct gekoppeld aan de efficiëntie van de gebruikte hardware.
Volgens technische gegevens over de geschiedenis van computerhardware oversteeg de jaarlijkse verbetering in hardwareprestaties tussen 1986 en 2003 de 50 procent. Deze enorme groei maakte de ontwikkeling van moderne apparaten mogelijk, wat de basis vormt voor de huidige eisen aan AI-hardware.
Het begrijpen van deze historische groei helpt om de huidige noodzaak voor gespecialiseerde versnellers te verklaren. Zonder deze constante vooruitgang zouden complexe algoritmen nooit op consumentenhardware kunnen draaien.
Hardwareversnelling vermindert de latentie en verhoogt de doorvoersnelheid van modelinferentie aanzienlijk.
Hoe verhoudt lokaal LLM draaien snel zich tot cloudoplossingen?
Ik staar naar het scherm in de late avond en vraag me af waarom de lokale snelheid zo verschilt van de cloud.
Een programmeur vergelijkt de latency van een lokale server met de reactiesnelheid van een API-verbinding via de cloud. De ene verbinding is direct, terwijl de andere afhankelijk is van de stabiliteit van het internet.
Volgens de National Aeronautics and Space Administration waren de bevindingen van een 10 maanden durende studie die in februari 2011 werd uitgevoerd door de National Highway Traffic Safety Administration (NHTSA) en de National Aeronautics and Space Administration (NASA), gericht op het identificeren van de hoofdoorzaak van plotselinge versnelling in Toyota- en Lexus-modellen.
De vergelijking tussen lokaal en cloud draait om de balans tussen privacy, kosten en snelheid. Waar een lokaal systeem volledige controle biedt, biedt de cloud bijna onbeperkte rekenkracht zonder dat er fysieke hardware aanwezig hoeft te zijn.
| Kenmerk | Lokale Hardware | Cloudoplossingen |
|---|---|---|
| Controle | Volledige privacy en controle | Afhankelijk van provider |
| Schaalbaarheid | Beperkt door fysieke componenten | Vrijwel onbeperkt |
| Initiële Kosten | Hoge aanschafwaarde | Operationele kosten (Pay-as-you-go) |
Het kiezen van de juiste omgeving hangt af van de gebruikte middelen. Wanneer men lokaal LLM draaien snel wil maken, moet men investeren in krachtige GPU's.
In deze vergelijking is de tweede stap de meest uitgebreide.
Hoe belangrijk is rekenkracht voor mijn model?
In de late avond staart de gebruiker naar het flikkerende scherm en denkt na over waarom de rekenkracht zo cruciaal is voor de reactie van het model. Een technicus controleert de temperatuur van een workstation terwijl een groot taalmodel wordt geladen. De fans draaien op vol vermogen om de warmte van de versnellers af te voeren.
Model draaien rekenkracht is de grootste uitdaging bij het werken met Large Language Models. De rekenkracht moet niet alleen hoog genoeg zijn voor de berekeningen zelf, maar ook voor het geheugenbeheer van de parameters.
Efficiëntie in het gebruik van hardware versnelling LLM betekent dat de rekenkracht optimaal wordt benut voor de specifieke architectuur van het model. Dit kan via GPU's, TPU's of andere gespecialiseerde chips die de wiskundige operaties versnellen.
Als de hardware niet voldoet aan de eisen, stagneert het proces volledig. Dit maakt de keuze voor de juiste componenten cruciaal voor elke AI-toepassing.
Rekenkracht bepaalt de snelheid waarmee tokens worden gegenereerd en de complexiteit van de modellen die kunnen worden uitgevoerd.
Hoe beïnvloedt de data-infrastructuur de LLM efficiëntie vergelijking?
Een systeembeheerder kijkt naar de opslagcapaciteit van een serverruimte vol met harde schijven en netwerkverbindingen. De data moet razendsnel van de opslag naar de rekenkern kunnen stromen.
De LLM efficiëntie vergelijking wordt vaak beïnvloed door de snelheid van de dataoverdracht tussen opslag en processor. Als de data-inlaat de rekenkracht niet kan bijhouden, ontstaat er een bottleneck.
In 2007 werd bijna 94% van de wereldwijd opgeslagen data digitaal bewaard, verdeeld over harde schijven (52%), optische apparaten (28%) en digitale magnetische tape (11%).
Deze verdeling laat zien hoe divers en verspreid digitale opslag is, wat impact heeft op de toegankelijkheid van data voor AI-modellen.
Het streamen van enorme datasets voor training of inferentie vereist een infrastructuur die deze digitale verspreiding aankan. Een snelle verbinding is daarom even belangrijk als de processor zelf.
De bandbreedte tussen opslag en rekenkracht is cruciaal om bottlenecks in de data-overdracht te voorkomen.
Hoe implementeer ik dit effectief lokaal? Een gebruiker installeert een nieuw besturingssysteem op een zwaar beveiligde workstation. De focus ligt op het configureren van de juiste drivers voor de grafische kaarten.
Voor wie kiest voor een lokale omgeving, zijn er specifieke stappen nodig om de prestaties te optimaliseren. Dit proces vereist een zorgvuldige planning van de hardware-architectuur.
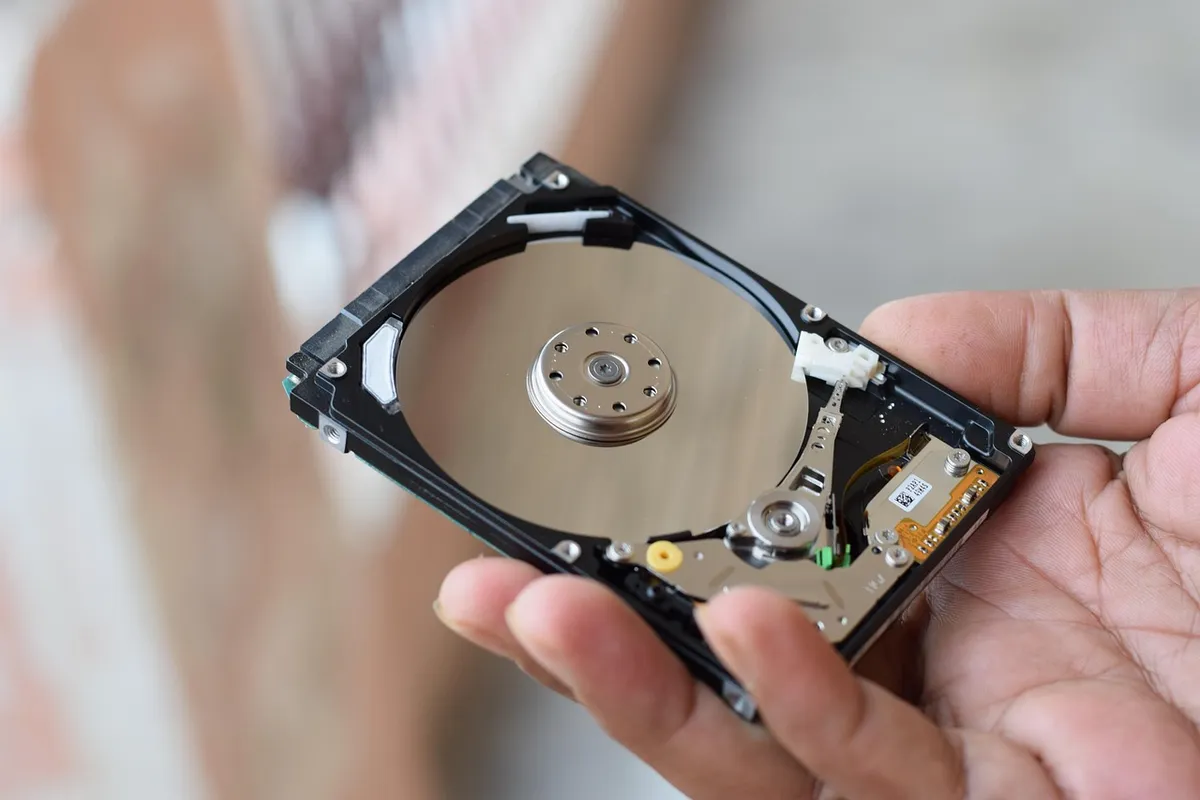
- Selecteer een GPU met voldoende VRAM om het volledige model in het geheugen te laden. 2. Configureer de software-omgeving en drivers voor optimale hardware-interactie. 3. Voer een stress-test uit om de stabiliteit en koeling onder volledige belasting te controleren.
Ik heb zelf tijdens het configureren van een lokale workstation gemerkt dat de balans tussen geheugenbandbreedte en rekenkracht essentieel is voor de stabiliteit. Een laatste check op de temperatuurregeling is altijd noodzakelijk om throttling te voorkomen.
Het is echter belangrijk om te onthouden dat lokale hardware beperkt is door de fysieke ruimte en de beschikbare energie.
- Selecteer de juiste hardware op basis van de modelgrootte.
- Configureer de software-omgeving en drivers.
- Optimaliseer de modelparameters voor de beschikbare rekenkracht.
Gerelateerd
- Welke risico's brengen autonome systemen met zich mee?
- 95% modellen: Open source vs gesloten model tips
Wanneer is de cloud de superieure keuze? De cloudoplossing is superieur wanneer de workload onvoorspelbaar is of wanneer de benodigde rekenkracht de fysieke grenzen van de lokale computer overschrijdt. Dit is vooral het geval bij het trainen van zeer grote modellen die enorme, constante berekeningen vereisen.
Het is een overweging die de gebruiker moet maken of de data-integriteit en de berekeningsbehoefte beter worden gedekt door een externe, schaalbare infrastructuur.
Voor een krachtige computer die lokale taken uitvoert, biedt de cloud een vangnet voor taken die de lokale componenten simpelweg niet aankunnen.
De cloud is superieur wanneer schaalbaarheid en toegang tot enorme rekenkracht belangrijker zijn dan lokale controle.
Wat zijn de operationele risico's van lokale implementatie? Het grootste operationele risico bij een lokale implementatie is de afhankelijkheid van de initiële hardwareselectie. Als de gekozen componenten niet voldoen aan de eisen, wordt het hele proces vertraagd of zelfs onbruikbaar.
Dit risico neemt toe naarmate de complexiteit van het te draaien model toeneemt, waardoor de noodzaak voor een diepgaande afweging vooraf cruciaal wordt.
De koeling van de krachtige computer moet dus niet alleen de piekbelasting aankunnen, maar ook stabiel blijven onder voortdurende belasting.
Reacties 0