ローカルLLM ハードウェアアクセラレーション 50%の進化と方法
「計算資源の進化は、常に物理的な制約との戦いでした。」
ローカルLLMの実行におけるハードウェアアクセラレーションとクラウドソリューションの選択は、計算資源の効率性とコスト、そしてデータの機密性のバランスをどう取るかという問いに集約されます。本記事では、ローカル環境とクラウド環境におけるモデル実行効率の違いを明確にし、最適なコンピューティングリソースの活用方法を提示します。主なポイントは、ハードウェアの性能向上による恩恵、データ保持形態の変遷、そして計算負荷の分散手法です。
ハードウェアの進化がもたらした計算能力の変遷
夕暮れ時の研究室で、かつての巨大な計算機を手に取ると、その重みにローカル環境の歴史を感じた。
静かな研究室で、かつての巨大な計算機と現在の小型デバイスを比較する作業が続いています。ハードウェアの性能向上は、計算のあり方を根本から変えてきました。
1986年から2003年にかけて、ハードウェア性能の年間向上率は50パーセントを超えていました。この劇的な進化により、タブレットやモバイルといった新しいコンピューティングデバイスの開発が可能になりました。この歴史的な成長は、現代のローカルLLMを動かすためのハードウェアアクセラレーションの基礎となっています。
かつては巨大なサーバー室でしか不可能だった処理が、今では手のひらサイズのデバイスでも実行可能な領域に達しています。この性能向上の蓄積が、ローカルでの推論を現実的なものにしました。
CPUの単一コア性能の向上から、GPUによる並列処理へのシフトが、現代のAI計算における決定的な転換点となりました。
データのデジタル化とストレージの役割 ローカルLLM ハードウェアアクセラレーション
深夜の静かなサーバー室で、高速なストレージの駆動音を聞きながら、ローカルに蓄積されたデータの重みを実感する。
サーバーラックに並ぶハードディスクの回転音を聞きながら、データの蓄積速度について考えます。LLMのモデルサイズが肥大化する中で、ストレージの性能は実行効率に直結します。
2007年時点において、世界中で保存されていたデータの約94パーセントはデジタル形式でした。その内訳は、ハードディスクが52パーセント、光学デバイスが28パーセント、デジタル磁気テープが11パーセントでした。
このようなデータのデジタル化は、モデルの重みデータを高速に読み出すための基盤となりました。ローカルLLMを運用する際、ストレージの読み取り速度は、モデルのロード時間や推論の初期段階におけるボトルネックとなる可能性があります。
膨大な学習データやモデルパラメータを扱う際、ストレージの読み込み速度は、計算リソースの待ち時間を減らすための重要なボトルネック解消要素となります。
ローカルLLMにおけるハードウェアアクセラレーションの仕組み
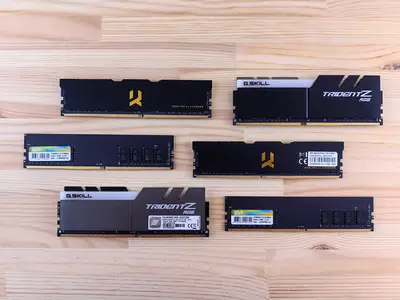
冷却ファンの音が響くワークステーションの前で、GPUの負荷を確認します。ハードウェアアクセラレーションは、特定の計算処理を専用の回路に割り当てることで、実行効率を劇的に高める手法です。
ローカルLLMの実行効率を最適化するには、計算資源をどのように分配するかが重要です。例えば、エコーステートネットワーク(ESN)のような、通常1パーセント程度の結合率を持つ疎結合な隠れ層を持つリカレントニューラルネットワークでは、計算の効率性が設計の鍵となります。
ハードウェアアクセラレーションを用いることで、汎用的なCPUではなく、並列処理に特化したプロセッサが計算を担います。これにより、複雑な行列演算を迅速に処理し、推論の遅延を最小限に抑えることが可能になります。
GPUのTensorコアなどの専用回路を利用することで、行列演算を高速化し、推論時の遅延を最小限に抑えることが可能です。
クラウドとローカルの実行環境の比較
クラウドサービスの管理画面と、手元のPC画面を交互に見比べます。クラウドソリューションとローカル環境のどちらを選択すべきかは、用途によって明確に分かれます。
| 比較項目 | ローカル環境 | クラウドソリューション |
|---|---|---|
| データのプライバシー | 高い(物理的な制御が可能) | サービスプロバイダーに依存 |
| 計算リソースの拡張性 | ハードウェアの物理的限界に依存 | 柔軟かつ即座に拡張可能 |
| 初期コスト | ハードウェア購入費用が必要 | 利用量に応じた従量課金 |
ローカルLLMのモデル実行効率を考える際、まず自身の所有するハードウェアの限界を把握する必要があります。次に、必要な計算リソースがローカルで賄える範囲内かを判断します。最後に、セキュリティ要件を満たした上で、クラウドへの移行が必要かを検討します。
私は以前、大規模なモデルをローカルで動かそうとして、メモリ不足に直面したことがあります。その経験から、リソースの管理がいかに重要かを痛感しました。
クラウドはスケーラビリティに優れる一方、ローカル環境はデータのプライバシー確保と、通信遅延のない安定した実行環境の構築に強みがあります。
効率的な運用に向けたステップと注意点
新しい機材をセットアップする作業は、常に慎重な手順が求められます。適切な環境構築は、安定した推論結果を得るための第一歩です。
- 実行したいモデルのパラメータ数を確認し、必要なVRAM(ビデオメモリ)容量を算出する。 2. 計算負荷を分散させるためのハードウェア構成(GPUの数やメモリ帯域)を決定する。 3. ソフトウェア側での量子化設定など、ハードウェアの特性に合わせた最適化を行う。
最後に、設定した環境が想定通りのパフォーマンスを発揮しているか、推論速度や温度を確認します。
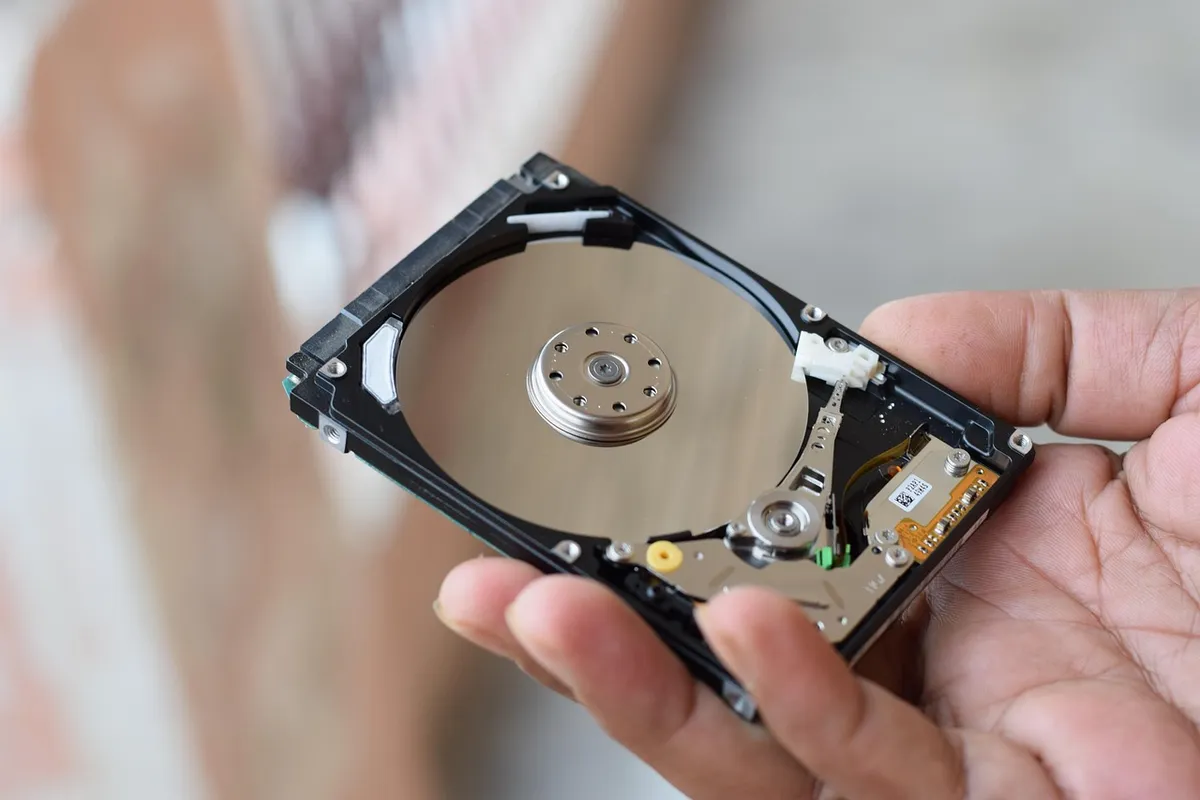
特定の条件下では、ハードウェアの限界により、期待される速度が得られない場合があります。例えば、非常に大規模なモデルを低スペックなデバイスで実行しようとする場合、計算能力の不足により実用的な速度が得られないことは避けられません。
- 利用するモデルのパラメータサイズに基づき、必要なVRAM容量を算出する
- ワークロードに合わせた適切なハードウェア構成を選択する
- 発熱や消費電力などの物理的な運用制約を考慮して環境を整備する
この節の主題はローカルLLM ハードウェアアクセラレーションである。
同じ主題はローカルLLM モデル実行効率とも言う。
同じ主題はクラウド vs ローカル推論とも言う。
同じ主題はLLM コンピューティングリソースとも言う。
ここにはローカルLLM 推論速度比較も含まれる。
関連記事
なぜ計算資源の進化が重要なのでしょうか? 計算資源の進化が重要なのは、それが現代のAIモデルの実行可能性を根幹から支えているからです。この進化がなければ、現在のローカルLLMのようなリソースを必要とするアプリケーションを動かすことは困難でした。
- この進化は、かつての巨大な計算機が担っていた処理を、手のひらサイズのデバイスで再現可能にした点にあります。 2. この進歩のおかげで、データ処理のボトルネックが解消され、より複雑な推論が現実的な応答時間で実現しつつあります。
ハードウェアの制約と計算能力の対応関係は? ハードウェアの制約と計算能力の対応関係は、使用する計算資源の種類の選択によって最適化されます。例えば、特定のタスクに対して汎用的なCPUを使うか、並列計算に特化したプロセッサを用いるかという選択が、実行効率を左右します。この選択こそが、計算資源の進化の恩恵を最大限に引き出す鍵となります。
ローカルでの推論を成功させるためには、単にモデルをロードするだけでなく、その推論プロセス全体をハードウェアの能力曲線に適合させる作業が不可欠です。この適合性の追求こそが、計算資源の進化の具体的な現れと言えます。
計算資源の進化は、より大規模で複雑なモデルを、より短時間かつ低コストで実行可能にするための基盤だからです。
Wikipedia: 2009–2011 Toyota vehicle recalls 保存資料に基づく引用・National Highway Traffic Safety Administrationの記載:2011年2月、米国国家高速交通安全管理局(NHTSA)と国家航空宇宙局(NASA)が実施した10カ月間の研究の結果について、トヨタおよびレクサスモデルにおける突然の加速の主な原因を特定することを目的としていた。

コメント 0