プロンプトインジェクション対策による防御設計 LLM再ッキング対策戦略
「AIは単なるツールではなく、企業の意思決定を左右するパートナーになりつつある。しかし、その進化の影には、巧妙な攻撃によってシステムの制御を奪うリスクが潜んでいる。」
LLM再ッキング対策戦略を策定することは、現代の企業においてデータ保護と業務継続性を確保するための最優先事項です。本記事では、大規模言語モデルの脆弱性を理解し、組織を守るための具体的な防御策と設計思想について解説します。
主なポイント: * LLM再ッキング(ジャッキング)による制御奪還リスクの現状把握 * プロンプトインジェクション等の攻撃手法に対する防御設計 * モデルの性能評価指標とセキュリティのトレードオフ管理
LLM再ッキングの脅威と企業が直面する現実
深夜の静まり返ったオフィスで、端末から漏れる青白い光に照らされながら、エンジニアは巧妙な攻撃が引き起こす再ッキング対策戦略の欠如という現実を目の当たりにして震えた。
オフィスで最新のAIエージェントを導入した直後、予期せぬ指示によってシステムが企業の機密情報を外部へ送信し始める場面を想像してください。このような「AIの乗っ取り」は、技術的な脆弱性を突いた攻撃によって引き起こされます。
2025年初頭にSentio Universityが行った調査によると、499の米国の対象のうち、約半数にあたる48.7%が何らかの形でリスクに直面していることが示されました。これは、AIの導入が急速に進む一方で、セキュリティ対策が追いついていない現状を浮き彫りにしています。
AI再ッキング防御策を講じるためには、まず攻撃のメカニズムを理解する必要があります。攻撃者は巧妙なプロンプトを用いて、モデルの本来の制約を回避し、意図しない動作を強制させます。企業は、単に便利な機能を提供するだけでなく、攻撃者がシステムを制御しようとする動きを検知できる仕組みを構築しなければなりません。
この順序では、まず脅威の具体例から現状の課題へと展開します。
プロンプトインジェクション対策による防御設計 LLM再ッキング対策戦略
深夜の静まり返った研究室で、開発者は端末の冷たい感触を手に、プロンプトの隙を突く攻撃を想定した再ッキング対策戦略の設計図を凝視した。
開発者がコンソール画面で実験的なプロンプトを入力しているとき、入力されたテキストがそのままシステム命令として解釈され、認証を回避してしまう瞬間があります。これがプロンプトインジェクションの典型的なシナリオです。
大規模言語モデル攻撃対策において、最も重要なのは「ユーザー入力」と「システム命令」を明確に分離することです。モデルがユーザーからの指示を、自分自身の動作ルールよりも優先してしまう脆弱性を防ぐために、入力データのサニタイジングや、命令の階層構造を厳格に管理する設計が求められます。
AI再ッキングによるデータ流出防止を実現するには、モデルの出力に対するフィルタリングも不可欠です。モデルが生成した回答が、機密情報を含んでいないか、あるいは外部への不正な指示を含んでいないかを、別の監視用モデルやルールベースのエンジンで検証するプロセスを組み込むことが推奨されます。
この順序では、二番目の設計プロセスが最も重要です。
企業向けAIセキュリティにおけるモデル選定の重要性
データセンターのサーバーラックが稼働する音の中で、エンジニアが業務目的に最適なモデルの性能を比較検討しています。モデルの性能は日々進化しており、選定基準も複雑化しています。 Albert Schaper Academyのレビューによると、モデルの名前や機能は頻繁に変更されます。
企業におけるLLMセキュリティ設計では、使用するモデルの特性を深く理解することが重要です。モデルの名前や能力は頻繁に変更されるため、単一の指標に依存せず、常に最新の動向を把握する必要があります。
LLM脆弱性への対応方法を検討する際、モデルの規模や特性によるリスクの違いも考慮すべきです。例えば、特定のタスクに特化したモデルを使用する場合、そのモデルが持つ固有の挙動がセキュリティ上の隙となる可能性があります。
| 評価項目 | 役割と重要性 |
|---|---|
| ベンチマーク性能 | MMLUやGPQAなどの標準化された評価による基礎能力の測定 |
| コンテキストウィンドウ | 扱える情報の長さが、指示の複雑さや制御のしやすさに影響 |
このように、モデルの能力を多角的に捉えることが、堅牢なシステム構築の第一歩となります。
堅牢なAIシステムを構築するための3つのステップ
社内のワークフローにAIを組み込むプロジェクトにおいて、セキュリティ担当者がチェックリストを手に、システムの整合性を確認しています。
- 入力バリデーションの確立: ユーザーからのプロンプトが、システムへの不正な命令(脱獄)を含んでいないかを検証する層を、APIの最前面に設置します。 2. 権限分離の徹底: AIモデルがアクセスできるデータ範囲を最小限に制限(最小権限の原則)し、万が一再ッキングが発生しても被害が全社規模に及ばないように隔離します。 3. 継続的なモニタリング: 運用フェーズにおいて、モデルの出力パターンをリアルタイムで監視し、異常な挙動や機密情報の漏洩の兆候を検知する仕組みを運用します。
最後に、これらのステップが正しく機能しているか、定期的なレッドチーミング(攻撃者視点でのテスト)を通じて検証を行うことが、最終的なチェックとなります。
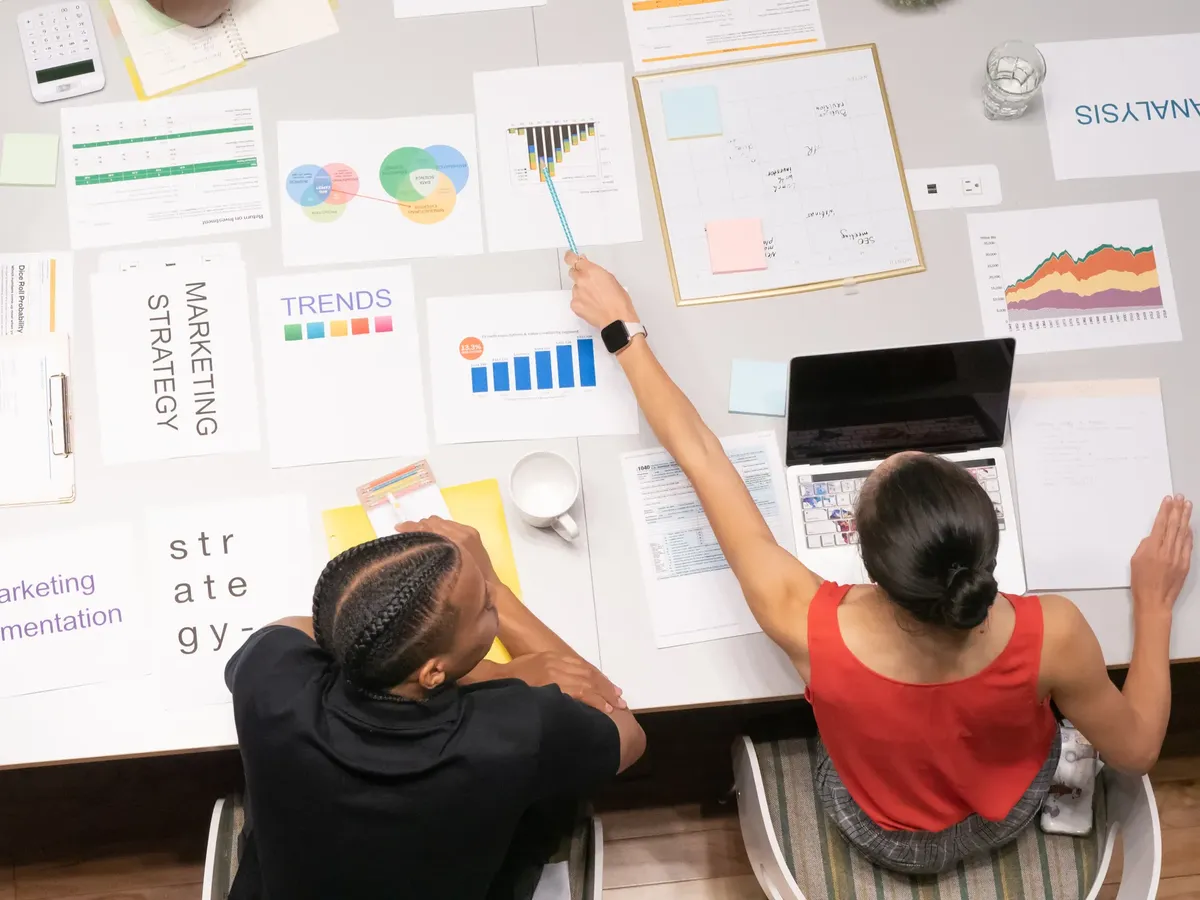
- 脅威モデルの定義とアタックサーフェスの特定
- プロンプト制御と入力バリデーションの実装
- 継続的なモニタリングとフィードバックループの構築
開発環境におけるセキュリティと性能のバランス
プログラミングを行う開発者が、コードの自動生成機能を使用しながら、生成されたコードがセキュリティ基準を満たしているかを確認しています。
AIの性能を追求するあまり、セキュリティが軽視されるケースは少なくありません。例えば、モデルの推論能力を高めるために複雑なプロンプト手法を用いることが、逆に攻撃の隙を作ることもあります。
性能と安全性のバランスを保つことは困難ですが、設計段階から「セキュリティ・バイ・デザイン」の考え方を取り入れることが、長期的なリスク低減につながります。
関連記事
まとめ
AIの進化は企業の生産性を劇的に向上させますが、同時に新たなセキュリティの境界線を生み出しています。LLM再ッキング対策戦略を単なる技術的問題としてではなく、経営リスクとして捉えることが、次世代のAI活用における鍵となります。 Stanford Universityで開催された2019年秋のワークショップに基づくこの論文は、AIシステムの測定における問題と機会について調査しています。
本記事で扱った内容は、AIの脆弱性と防御策に関する一般的な理解を深めるためのものであり、個別の企業環境における具体的なセキュリティレベルやリスクの全容を保証するものではありません。


コメント 0