16GB MacBook 推奨ローカルLLM 運用方法を解説
「16GBのメモリを積んだMacBookで、どの程度の規模のローカルLLMを動かすべきか」という問いは、多くのユーザーが直面する現実的な課題です。
16GB RAMのMacBookにおいて、最適なローカルLLMの選択は、モデルのパラメータ数と量子化によるメモリ消費量のバランスに依存します。本記事では、メモリ容量の制約内で最大限のパフォーマンスを引き出すためのモデル選定基準と、ハードウェアへの負荷を考慮した運用方法を解説します。
主なポイントは以下の通りです。 * 16GB RAMにおけるモデルサイズと量子化のトレードオフの理解 * 推論速度とメモリ使用量の関係性 * 高負荷なワークロードがハードウェアに与える潜在的な影響
16GB MacBook 推奨ローカルLLMの選定基準とは?
MacBookのキーボードを叩きながら、新しいモデルをダウンロードしようとする瞬間は常に期待に満ちています。しかし、16GBという限られたメモリ容量では、モデルのパラメータ数と量子化(Quantization)のバランスを慎重に検討する必要があります。
一般的に、16GBのメモリを搭載したモデルでは、7Bから14B程度のパラメータを持つモデルを量子化して使用するのが現実的なラインです。例えば、4ビット量子化を施した7Bモデルであれば、メモリ消費を抑えつつ、実用的な推論速度を維持できます。一方で、モデルが大きすぎると、OSの動作に必要なメモリが不足し、システム全体のパフォーマンスが著しく低下する恐れがあります。
メモリ不足によるスワップが発生すると、SSDへの書き込み負荷が増大し、システムの安定性が損なわれる可能性があるため、常に余裕を持った選択が求められます。
MacBook 16GB モデル比較におけるパラメータと量子化の相関
夜のデスクで、画面の光に照らされながら、macbookの熱を感じつつパラメータと量子化の関係を比較する。
作業スペースに広げたノートPCの画面で、モデルのロード状況を監視する作業は、ローカルLLM運用の日常的な風景です。メモリ容量に合わせたモデルの選択は、単なる速度の問題ではなく、継続的な利用における安定性の問題でもあります。
モデルのサイズを決定する要素は、主にパラメータ数と、それに対する量子化の精度です。16GBの環境では、モデルのサイズ(パラメータ数)を上げすぎると、文脈を保持するためのKVキャッシュ(Key-Value Cache)用のメモリが確保できなくなることがあります。
以下の表は、16GB RAM環境における一般的なモデル構成の目安です。
| モデル規模 | 推奨される量子化レベル | 期待される動作 |
|---|---|---|
| 7B - 8B クラス | 4-bit / 8-bit | 非常にスムーズな動作 |
| 13B - 14B クラス | 4-bit | 実用的な速度と精度のバランス |
このように、16GB RAM向けLLM選定においては、モデルの精度をどこまで犠牲にするかという判断が重要になります。
メモリ16GB向けLLM選定で避けるべきリスク
深夜の静かな部屋で、ファンが激しく回転するMacBookの音を聞きながら、作業の継続を検討する場面があります。高負荷な推論を繰り返すと、メモリの挙動や熱管理がシステムの寿命に影響を与える可能性を無視できません。
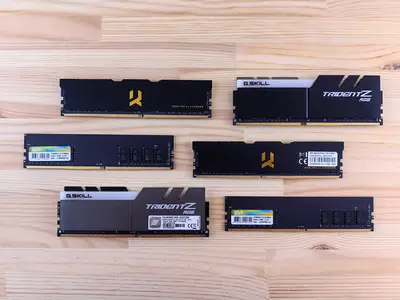
高負荷なワークロードは、ハードウェアに物理的な負荷をかけます。ある事例では、35BクラスのローカルLLMによる高負荷なワークロードが、わずか90分間で古いDDR4 RAMスティックを破損させたという報告があります。ユーザーは温度管理は万全であったと主張していましたが、メモリへの負荷は予測困難な挙動を引き起こすことがあります。
16GB MacBookでのローカルLLM活用術として、常にメモリ使用率の推移を監視し、システムの限界を超えない範囲でモデルを運用することが、ハードウェアを長持ちさせる鍵となります。
MacBook ローカルLLM 性能を最大限に引き出すための3ステップ
実験室のようなデスクで、新しいプロンプトを入力し、モデルの応答を待つ時間は、技術的な検証の連続です。安定した環境を構築するためには、以下の手順で設定を確認することをお勧めします。
- モデルの量子化レベルの決定: 16GBのメモリを最大限活用するために、まずは4-bitや5-bit程度の量子化モデルを選択し、OSの基本動作に必要なメモリを確保します。 2. コンテキストウィンドウの調整: 推論時に使用されるメモリ量を制御するため、モデルの設定でコンテキスト長(Context Length)を適切に制限します。 3. 負荷テストと安定性の確認: 実際にモデルを動かし、メモリ使用率がスワップを過度に発生させていないか、システムが安定しているかを確認します。
最後に、これらのステップを通じて、使用しているモデルが環境に適しているかを最終チェックしてください。
- 使用するモデルのパラメータ数と量子化ビット数を計算し、メモリ使用量の予測を行う。
- OSや他のアプリケーションのメモリ消費を抑えるため、不要なプロセスを終了させる。
- 推論エンジンを適切に設定し、GPUへのメモリ割り当てを最適化する。
16GB RAM LLM 最適化における限界と注意点
窓の外が明るくなるまで作業を続け、モデルの挙動を観察していると、ハードウェアの限界を感じることがあります。16GBのメモリは、特定の条件下では十分な性能を発揮しますが、万能ではありません。
特定の条件下では、モデルのサイズが大きすぎると、推論が極端に遅くなる、あるいはプロセスが強制終了されることがあります。例えば、非常に高い精度を求めて量子化を最小限にした大型モデルを無理に動かそうとすると、メモリ不足によりシステムが不安定になる可能性があります。
16GB RAMでのモデル比較において、高いパラメータ数のモデルを動かすことは魅力的ですが、それは常にメモリの物理的な限界との戦いであることを忘れてはいけません。
この節の主題は16GB MacBook 推奨ローカルLLMである。
ここにはメモリ消費量とモデル性能の相関も含まれる。
ここにはMacBook向け軽量LLM活用術も含まれる。
関連記事
コメント 0