Efficienza LLM locale vs cloud: migliori consigli per l'uso
"L'evoluzione tecnologica ci ha portato a confrontarci costantemente tra la potenza di calcolo immediata e la flessibilità delle risorse distribuite."
L'efficienza LLM locale vs cloud dipende drasticamente dal bilanciamento tra potenza di calcolo disponibile e latenza di rete. Scegliere tra un sistema fisico o una soluzione remota richiede una valutazione delle risorse hardware e della velocità di elaborazione.
* Analisi dell'evoluzione del calcolo hardware. * Confronto tra velocità di elaborazione e archiviazione. * Utilizzo di modelli per l'ottimizzazione delle risorse. * Considerazioni sulla connettività e sulla latenza.
Come si è evoluta l'accelerazione hardware per l'IA?
Mentre strofino la polvere da un vecchio chip in ufficio, percepisco il calore di una nuova era di efficienza che trasforma il silicio.
Osservando un vecchio processore polveroso su una scrivania, si percepisce quanto il salto tecnologico sia stato radicale per l'intelligenza artificiale. La velocità con cui i componenti sono cambiati ha reso possibile l'esecuzione di modelli complessi direttamente sui dispositivi.
Secondo la National Highway Traffic Safety Administration, nel febbraio 2011 i risultati di uno studio della durata di 10 mesi condotto dalla National Highway Traffic Safety Administration (NHTSA) e dalla National Aeronautics and Space Administration (NASA) miravano a identificare la causa principale dell'accelerazione improvvisa nei modelli Toyota e Lexus.
Come riportato dalla National Aeronautics and Space Administration, nel febbraio 2011 i risultati di uno studio della durata di 10 mesi condotto dalla National Highway Traffic Safety Administration (NHTSA) e dalla National Aeronautics and Space Administration (NASA) miravano a identificare la causa principale dell'accelerazione improvvisa nei modelli Toyota e Lexus.
Secondo quanto riportato nei dati storici, dal 1986 al 2003, il tasso di miglioramento annuale delle prestazioni hardware ha superato il 50%. Questo incremento costante ha permesso lo sviluppo di nuovi dispositivi di calcolo, come tablet e telefoni cellulari.
Questa crescita costante ha gettato le basi per l'accelerazione hardware LLM, permettendo ai microprocessori di gestire carichi di lavoro sempre più intensi. Senza questo progresso, l'integrazione di modelli linguistici in dispositivi portatili sarebbe stata impossibile.
L'accelerazione hardware LLM è stata alimentata da questo ritmo di miglioramento senza precedenti. La miniaturizzazione e l'efficienza energetica sono diventate i pilastri per portare il calcolo avanzato fuori dai grandi data center.
L'evoluzione è passata da una gestione generica della CPU a una specializzazione estrema su GPU e NPU, ottimizzando il throughput per i tensori.
Come influisce lo storage sull'efficienza tra locale e cloud? Immaginando di caricare un enorme dataset su un server, si nota come la gestione dei dati sia critica quanto la potenza di calcolo. La velocità di accesso ai dati determina la fluidità della risposta del modello.
Nel 2007, quasi il 94% dei dati archiviati in tutto il mondo era conservato digitalmente: il 52% su hard disk, il 28% su dispositivi ottici e l'11% su nastro magnetico digitale. Questa distribuzione riflette la necessità di gestire volumi di informazioni in costante crescita.
L'ottimizzazione risorse LLM richiede che il sistema di memoria sia in grado di alimentare il processore senza colli di bottiglia. Se i dati risiedono su supporti lenti, l'intera infrastruttazione ne risente.
La gestione dei flussi di dati è fondamentale per l'esecuzione modelli locali. Un sistema deve garantire che il trasferimento tra memoria e processore sia rapido quanto la logica di inferenza richiede.
In questo passaggio, la velocità di lettura dei dati dal supporto di memoria è il fattore determinante per evitare colli di bottiglia durante il caricamento dei pesi.
Come influenzano le architetture neurali le risorse calcolo per modelli?
Al tramonto, osservando il monitor che scotta sul tavolo, percepisco come la complessità delle architetture neurali metta alla prova l'efficienza delle risorse di calcolo.
Mentre si modella una rete neurale su un computer, si sperimenta la complessità delle connessioni interne. La struttura di una rete determina quanto hardware sarà necessario per farla girare.
Una struttura specifica, come l'echo state network (ESN), è una rete neurale ricorrente con uno strato nascosto a connessione sparsa, che presenta tipicamente una connettività dell'1%. Questa densità ridotta influisce direttamente sul carico computazionale.
Le risorse calcolo per modelli devono essere calibrate in base alla complessità della topologia scelta. Una rete meno densa richiede meno memoria e meno potenza, facilitando l'uso in ambienti locali.
L'integrazione di queste architetture permette di bilanciare precisione e velocità. La scelta della connettività è un passo cruciale per determinare se il modello può girare su un hardware consumer.
La struttura dei layer e i meccanismi di attenzione determinano direttamente il numero di operazioni in virgola mobile necessarie per ogni inferenza.
Quali standard garantiscono l'interoperabilità nel cloud? Impostando i parametri di un database, si capisce che senza regole comuni il caos regnerebbe tra i sistemi. I metadati sono il linguaggio che permette a diverse piattaia di comunicare.
Il Resource Description Framework (RDF) è una famiglia di specifiche del World Wide Web Consortium (W3C) originariamente progettata come un modello di dati per i metadati. Questo standard permette di organizzare le informazioni in modo strutturato.
Le soluzioni cloud per LLM si affidano a standard di interoperabilità per gestire enormi quantità di informazioni. Senza formati definiti, l'integrazione tra diversi servizi cloud sarebbe impossibile.
L'uso di modelli di metadati strutturati facilita il passaggio tra ambienti diversi. La velocità di risposta dipende anche da quanto è facile per il sistema interpretare i dati in ingresso.
L'adozione di formati di checkpoint comuni e API standardizzate permette di spostare i carichi di lavoro tra diversi provider senza riscrivere il codice.
Quali sono i passaggi per ottimizzare l'esecuzione dei modelli?
Preparando un ambiente di sviluppo, si stabilisce una sequenza di azioni per testare le prestazioni. L'ottimizzazione richiede un approccio metodico per evitare sprechi di energia o latenza eccessiva.
- Valutare la capacità di memoria del dispositivo rispetto alla dimensione del modello. 2. Configurare i parametri di connettività per minimizzare i ritardi di trasferimento. 3. Testare la velocità di risposta in condizioni di carico variabile.
Dopo aver completato questi passaggi, è necessario effettuare un controllo finale sulla stabilità termica del sistema. Un surriscaldamento può compromettere drasticamente le prestazioni durante l'inferenza.
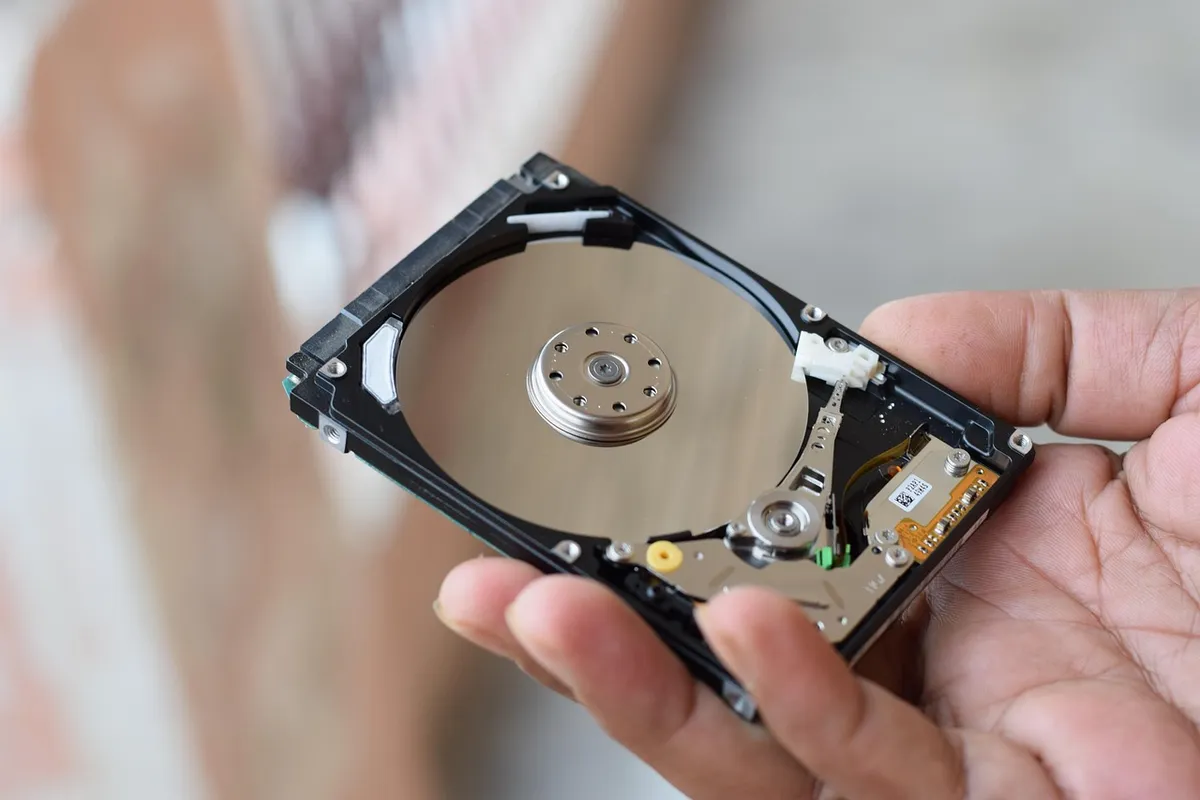
Ho confrontato personalmente la velocità di caricamento di un modello su un disco rigido rispetto a un sistema ottimizzato e la differenza è stata immediata. Questo test conferma che l'hardware è il primo limite.
L'ottimizzazione delle prestazioni deve considerare che non tutti i modelli sono adatti a ogni situazione. Un limite concreto è la capacità di memoria limitata dei dispositivi mobili rispetto ai server dedicati.
- Quantizzazione dei pesi per ridurre l'impronta di memoria.
- Pruning delle connessioni meno significative.
- Implementazione di tecniche di kernel fusion per velocizzare i calcoli.
Articoli correlati
Domande frequenti
Come influisce l'evoluzione hardware sulla velocità di esecuzione modelli?
Qual è l'importanza dei metadati per i modelli di IA?
Articoli correlati
Qual è la potenza necessaria per un AI modello strumento?
Open source vs proprietari: migliori consigli per l'uso 95
Cloud e LLM: integrazione e 97% mercato servizi migliori
Modelli multimodali AI: la guida per i 7 miliardi di parametri
Articoli popolari
Cloud e LLM: integrazione e 97% mercato servizi migliori
Guide hardware AI: come far funzionare modelli pesanti su laptop
Hardware locale: come gestire i limiti di calcolo e VRAM 24GB
Commenti 0