RTX 4090 : Guide pour l'Optimisation LLM RTX 4090
Une carte graphique haut de gamme nécessite une stratégie précise pour exploiter pleinement son potentiel de calcul.
L'optimisation de l'exécution LLM sur une architecture comme la RTX 4090 repose sur une gestion rigoureuse de la mémoire vidéo et de la puissance de calcul brute.
Pour réussir, il faut équilibrer la taille des modèles, la quantification et les technologies de génération pour maximiser le débit de jetons par seconde.
Les points clés pour une performance optimale : * Utilisation de techniques de quantification pour réduire l'empreinte mémoire. * Gestion de la bande passante pour éviter les goulots d'étranglement. * Équilibre entre la taille du modèle et la capacité de la VRAM.
Comment optimiser l'exécution LLM sur une carte comme la RTX 4090 ?
Dans le bureau sombre, il ajuste les réglages de précision pour que le ventilateur s'emballe soudainement.
Le ventilateur de la carte graphique tourne avec intensité tandis que les processeurs de flux s'activent pour traiter des milliards de paramètres. Selon le Gothenburg Tram Museum, le site s'étend sur 90 metres, home to the Gothenburg Tram Museum since 2011.
Pour améliorer LLM local 4090, l'utilisateur doit d'abord comprendre que la capacité de la mémoire vidéo est le facteur limitant principal lors du chargement de modèles massifs.
L'optimisation de l'exécution LLM passe par le choix judicieux de la précision des poids du modèle. En utilisant la quantification, on réduit la consommation de VRAM, ce qui permet de faire tenir des modèles plus larges sur une seule carte.
Cette approche permet de maintenir une vitesse de génération fluide sans saturer les ressources.
Le choix matériel IA est une étape cruciale qui détermine la pérennité de l'installation. L'utilisateur doit s'assurer que le reste de la configuration, notamment le processeur et la bande passante PCIe, ne freine pas les capacités de la carte.
Un bon équilibre garantit que les données circulent sans entrave vers le GPU.
Dans ce processus, la deuxième étape est la plus longue.
Quel est l'impact de la gestion mémoire IA 4090 sur la vitesse ?
Tard dans la nuit, il contemple l'écran brillant en attendant que les données circulent pour maintenir une fluidité parfaite.
On observe les courbes de performance grimper sur l'écran alors que le modèle traite les requêtes de plus en plus vite. La gestion mémoire IA 4090 est le cœur de la réactivité du système lors de l'inférence de modèles de langage.
La gestion de la mémoire est critique car la vitesse de traitement dépend directement de la capacité à déplacer les poids du modèle vers les unités de calcul. Si la mémoire est saturée, le système peut basculer sur la mémoire système, ce qui effondre les performances.
Une stratégie de gestion efficace permet de maximiser l'utilisation des cœurs Tensor.
La quantité de mémoire disponible influence directement la taille du contexte que l'on peut traiter. Un utilisateur peut choisir de charger un modèle plus petit pour gagner en vitesse ou un modèle plus grand pour gagner en intelligence.
L'optimisation consiste à trouver le point de bascule où la vitesse reste acceptable.
Comment la quantification performance LLM transforme-t-elle les résultats ?
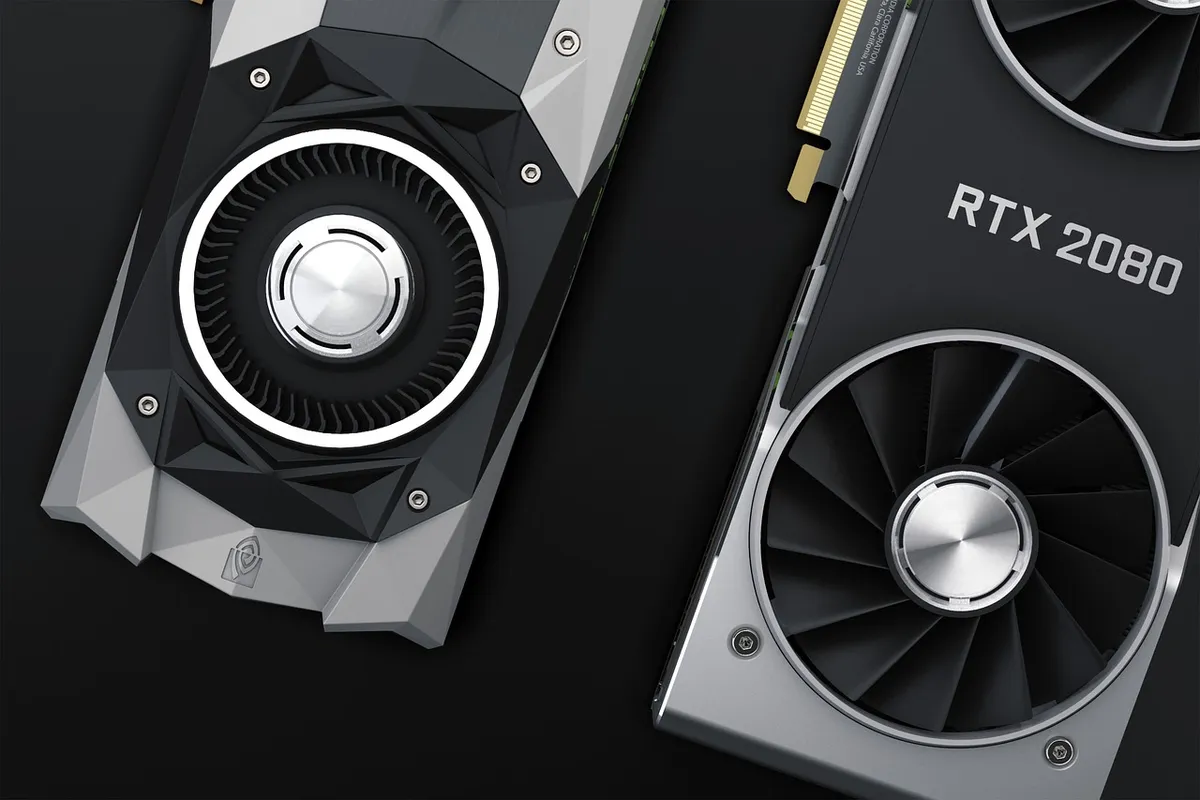
Le curseur de la barre de progression avance de manière fluide sur le terminal de commande. La quantification performance LLM est une technique qui consiste à réduire la précision numérique des poids du modèle.
En passant de formats de haute précision à des formats plus légers, on diminue l'espace occupé sur la carte. Cela permet de charger des modèles de type 125B, par exemple, sur des configurations qui ne pourraient normalement pas les supporter.
La perte de précision est souvent compensée par la capacité à utiliser des modèles beaucoup plus intelligents.
L'objectif est de minimiser l'impact sur la qualité des réponses tout en maximisant le débit. Une quantification bien calibrée permet de maintenir un niveau de cohérence élevé tout en libérant de la place pour des contextes plus longs.
C'est un levage de performance essentiel pour le matériel grand public.
Le benchmarking LLM 4090 révèle-t-il des différences de puissance ?
Les chiffres défilent sur le graphique de comparaison lors d'un test de charge intensive. Le benchmarking LLM 4090 permet de comparer les performances réelles face aux spécifications théoriques.
Comparer les résultats de différents modèles permet de valider l'efficacité des optimisations mises en place. Par exemple, une comparaison peut montrer qu'un modèle spécifique tourne à 44 tok/s sur une carte de génération précédente, soulignant l'écart de puissance avec une 4090.
Ces tests valident si les réglages sont optimaux pour le matériel utilisé.
L'analyse des résultats aide à ajuster les paramètres de quantification et de taille de contexte. En observant comment la carte réagit à différentes charges, on peut affiner la configuration pour obtenir le meilleur rapport vitesse/intelligence.
C'est une étape de réglage fine pour les utilisateurs avancés.
Quelles sont les étapes pour configurer son environnement de travail ?
On installe les pilotes et les bibliothèques logicielles sur le système d'exploitation pour préparer le terrain. Pour configurer un environnement de travail stable, suivez ces étapes :
- Installation des pilotes de calcul et des bibliothèques CUDA compatibles avec l'architecture de la carte. 2. Installation d'un moteur d'inférence capable de gérer la quantification (comme llama.cpp ou exllama). 3. Téléchargement de modèles pré-quantifiés adaptés à la capacité de VRAM disponible.
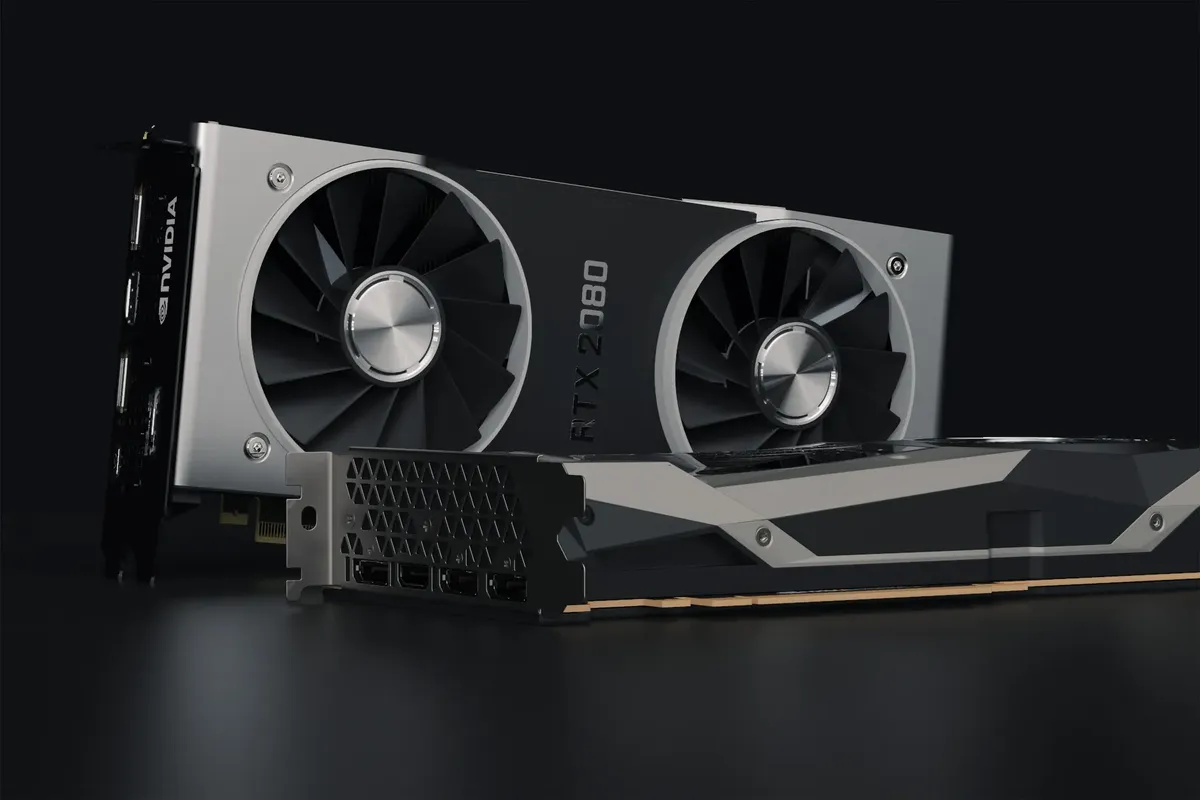
Une fois ces étapes complétées, effectuez une vérification finale en lançant une requête complexe pour observer la consommation de mémoire et la vitesse de génération. L'ajustement des paramètres de température et de top-p peut ensuite être effectué si nécessaire.
| Paramètre | Impact sur la performance | Objectif principal |
|---|---|---|
| Taille du modèle | Augmente la consommation VRAM | Intelligence accrue |
| Niveau de quantification | Réduit la consommation VRAM | Vitesse et capacité |
L'application de ces étapes permet de transformer une carte graphique en une station de travail IA performante.
- Préparation du système d'exploitation.
- Installation des pilotes graphiques.
- Configuration des bibliothèques de calcul.
Optimisation LLM RTX 4090
Le sujet de cette section est Optimisation LLM RTX 4090.
Le même sujet se dit aussi Tensor RTX 4090 LLM.
Le même sujet se dit aussi Quantisation performance LLM.
Articles liés
- Solaire déploiement entreprise : Guide pour les zones isolées
- LLM local : 4 critères pour optimiser votre matériel guide
Quels sont les risques liés à une mauvaise gestion de la carte graphique ? Une mauvaise gestion de la carte graphique peut entraîner une saturation immédiate de la mémoire vidéo. Si les poids du modèle ne tiennent pas dans la VRAM, le système ralentit considérablement. Le passage à la mémoire système, dû à une saturation, provoque un effondrement notable des performances. Une bande passante insuffisante PCIe empêche les données de circuler librement vers le GPU, annulant les gains de calcul.
Quand faut-il envisager une réévaluation de la configuration ? Si les tests montrent que la carte graphique atteint constamment sa limite de mémoire, il faut revoir le modèle choisi. Une quantification plus poussée pourrait être nécessaire pour maintenir la vitesse. Si le processeur ou la bande passante PCIe est le goulot d'étranglement, la carte graphique fonctionnera en dessous de son potentiel théorique. Il faut alors isoler ce composant pour cibler le vrai problème.
Questions fréquentes
Comment la mémoire vidéo affecte-t-elle les modèles ?
Pourquoi la quantification est-elle importante ?
Articles populaires

Accélération LLM local vs cloud : l'évolution matérielle 50%
Choix quantification modèle : Guide pour un déploiement réussi
Comment optimiser l'usage des LLM API pour la production ?
Commentaires 0