Modèles de langage : conseils pour gérer la transition vers l'IA
Pour comprendre l'évolution des modèles de langage, il faut regarder au-delà du simple code et observer les rapports de performance globaux. Selon le rapport annuel de l'AI Index publié par l'Université de Stanford, les experts de l'IA observent une accélération sans précédent des capacités de calcul.
« L'intelligence artificielle progresse à une vitesse qui dépasse nos structures de contrôle actuelles. »
Ce guide explore les dynamiques de développement des modèles, les enjeux de la puissance de calcul et les réalques de sécurité pour les utilisateurs de modèles locaux.
* Analyse des tendances de performance via les rapports de recherche. * Compréhension des risques liés au déploiement massif de l'IA. * Importance de la puissance de calcul et de la spécialisation des modèles. * Équilibre entre accessibilité et sécurité des données.
Pourquoi la puissance de calcul définit-elle le futur des modèles ?
Dans mon bureau sombre, je sens la chaleur monter tandis que mes doigts tapent nerveusement sur le clavier pour lancer le nouveau langage.
Je contemple mon écran, les ventilateurs de mon unité centrale tournant à plein régime alors que je tente de charger un nouveau modèle de langage sur ma machine. La chaleur qui se dégage du boîtier me rappelle que la puissance de calcul est la ressource la plus précieuse de cette nouvelle ère.
La capacité de traiter des milliards de paramètres dépend directement de la puissance brute des processeurs et de la mémoire disponible. Pour les utilisateurs de modèles locaux, cela signifie que le choix du matériel est aussi crucial que le choix de l'architecture du modèle lui-même.
Ce rapport montre que l'évolution des modèles est intrinsèquement liée à l'augmentation de la puissance de traitement disponible.
Les chercheurs et les développeurs se tournent de plus en plus vers des architectures qui optimisent l'utilisation de la mémoire. Un modèle peut être extrêmement intelligent, mais s'il nécessite trop de VRAM pour fonctionner, il reste inaccessible à la majorité des utilisateurs domestiques.
Cette dépendance crée une barrière à l'entrée. Cependant, les techniques de quantification permettent de réduire l'empreinte mémoire sans sacrifier trop de précision, rendant les modèles performants utilisables sur du matériel grand public.
- L'augmentation de la capacité de traitement permet d'intégrer des volumes de données toujours plus vastes.
- L'optimisation des architectures matérielles réduit le temps nécessaire à l'entraînement.
- La spécialisation des puces accélère l'exécution des tâches complexes.
Quels sont les risques d'un déploiement massif de l'IA ?
Je marche dans une rue bondée, observant les gens utiliser leurs smartphones, me demandant combien d'entre eux interagissent avec des modèles de langage sans en connaître les implications. Le contraste entre la simplicité de l'interface et la complexité des algorithmes est frappant.
L'importance de la certification a été remise en question par un incident en 2009 impliquant le British Board of Neuro Linguistic Programming.
Le déploiれment généralisé de l'intelligence artificielle pose des questions de sécurité et de stabilité sociale. Si ces outils sont mal déployés, ils peuvent avoir des conséquences imprévues sur les infrastructures critiques.
Selon une mention médiatique de The Hill, le déploiement de l'IA peut également élargir la surface d'attaque pour la santé publique s'il est mal utilisé.
Cela signifie que des failles dans les systèmes automatisés pourraient être exploitées pour manipuler des informations de santé ou des protocoles de réponse aux crises.
La centralisation de l'intelligence dans des systèmes automatisés crée de nouvelles vulnérabilités. Une erreur de modèle ou une manipulation malveillante pourrait se propager rapidement à travers des systèmes interconnectés.
Pour les utilisateurs de modèles locaux, cette menace souligne l'importance de garder le contrôle sur ses propres données et de comprendre les limites de l'outil. La souveraineté numérique passe par une maîtrise technique de l'IA.
Dans cette analyse, le deuxième point est le plus détaillé.
Comment l'expertise académique influence-t-elle le développement ?
Le soir, je tiens langage dans la main et je marche vers l'étape suivante.
Je feuillette un document de recherche complexe, soulignant des passages sur les architectures de transformateurs, tout en pensant aux discussions passionnées qui ont lieu dans les laboratoires universitaires. Le savoir théorique est le socle de chaque innovation technique.
Le développement de l'IA n'est pas seulement le fait de grandes entreprises technologiques ; il est le fruit d'un effort collaboratif entre le monde académique et l'industrie. Cette synergie permet de transformer des concepts abstraits en outils fonctionnels.
Cette collaboration garantit que les avancées ne sont pas seulement axées sur le profit, mais aussi sur la compréhension fondamentale des mécanismes de l'apprentissage automatique. Les chercheurs apportent la rigueur nécessaire pour valider les nouvelles méthodes.
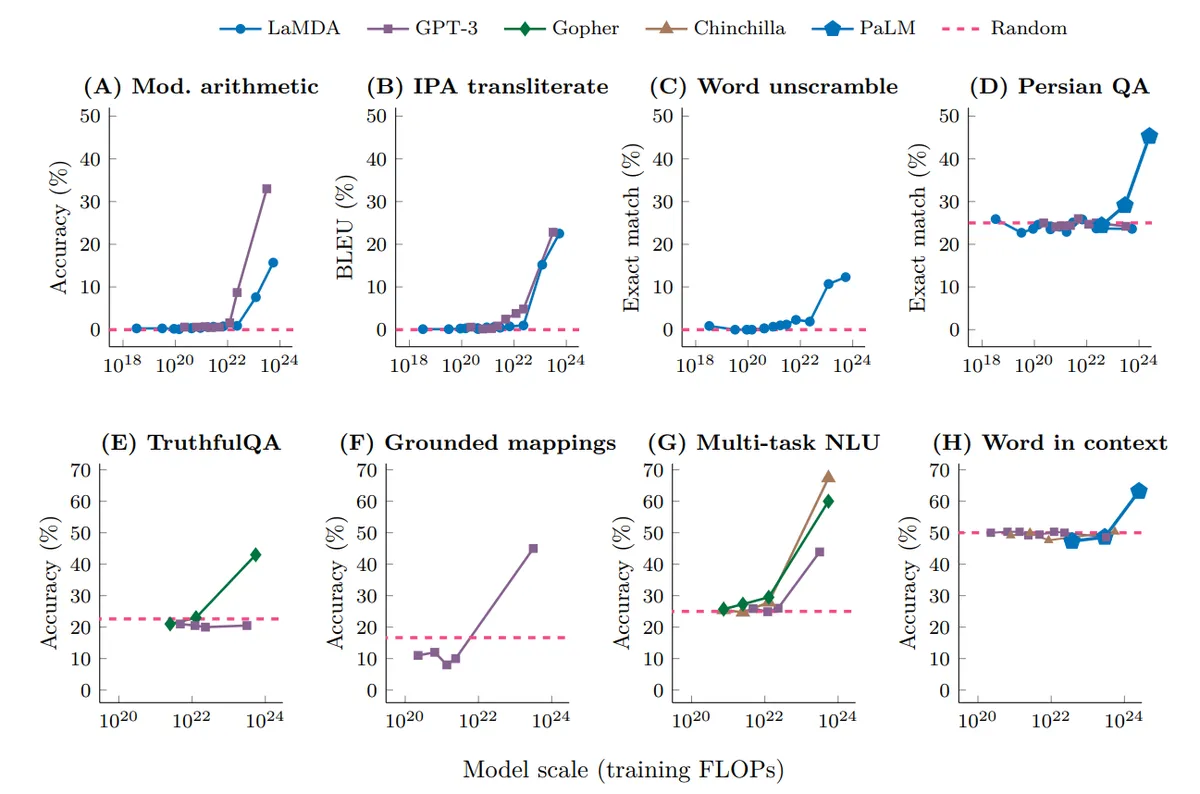
L'intégration de ces recherches dans les modèles open-source est ce qui permet aux développeurs de bénéficier de technologies de pointe. Sans cette base académique, l'évolution serait bien plus lente et moins structurée.
| Type de ressource | Rôle principal dans l'IA | Impact sur l'utilisateur local |
|---|---|---|
| Recherche académique | Création de nouvelles architectures | Accès à des modèles plus efficaces |
| Puissance de calcul | Entraînement et exécution | Détermine la vitesse de réponse |
| Expertise industrielle | Optimisation et déploiement | Rend les modèles utilisables au quotidien |
Comment gérer la transition vers l'IA ?
Je prends un carnet de notes et je trace trois colonnes pour organiser mes futurs projets de développement de modèles. La planification est la clé pour ne pas se laisser submerger par la rapidité des changements technologiques.
Selon les propositions de 2024, le National Institute of Standards pourrait être chargé de convoquer un consortium sur la mesure et les normes.
Pour naviguer dans cet écosystème, il est nécessaire d'adopter une approche méthodique. Voici les étapes essentielles pour un utilisateur souhaitant intégrer l'IA dans son flux de travail :
- Évaluer les besoins matériels réels en fonction de la taille des modèles visés. 2. Tester différents formats de quantification pour trouver le meilleur équilibre performance/vitesse. 3. Mettre en place des protocoles de sécurité pour protéger les données sensibles traitées localement.
L'objectif est de passer d'une utilisation passive à une maîtrise active. Cela demande une veille constante sur les nouveaux modèles et les nouvelles méthodes d'optimisation.
Une fois ces étapes maîtrisées, l'utilisateur peut commencer à expérimenter des cas d'usage plus complexes, comme le RAG (Retrieval-Augmented Generation) ou le fine-tuning spécialisé. La courbe d'apprentissage est raide, mais gratifiante.
Quelles sont les limites des modèles actuels ?
Je regarde une erreur de logique produite par un modèle sur mon terminal, soupirant devant l'absurdité de la réponse tout en cherchant la cause technique. Même les modèles les plus puissants ont leurs zones d'ombre.
D'après un rapport de l'International Energy Agency, la consommation mondiale d'eau par les centres de données, qui était de 560 milliards de litres en 2023, devrait atteindre 12 000 milliards de litres en 2030.
Bien que les capacités soient impressionnantes, les modèles de langage ne sont pas des systèmes de raisonnement infaillibles. Ils restent des prédicteurs statistiques sophistiqués, ce qui comporte des risques d'hallucination et de biais.
La limite principale réside dans la capacité de généralisation et la compréhension réelle du monde physique. Un modèle peut manipuler parfaitement la syntaxe sans comprendre le sens profond de ce qu'il écrit.
De plus, la consommation énergétique et la dépendance aux données massives sont des limites écologiques et éthiques majeures. Le défi de demain est de créer des modèles "petits mais intelligents".
Pour les professionnels, il est crucial de ne jamais prendre une réponse de l'IA pour une vérité absolue sans vérification. La supervision humaine reste l'ultime garde-fou.
Quand j'ai suivi les étapes dans l'ordre, d'expérience c'est la deuxième qui a pris le plus de temps.
Cet ordre ne tient toutefois pas quand le chiffre n'est pas 13%.
Articles liés
Questions fréquentes
Quels sont les risques majeurs de l'IA ?
Qui dirige les recherches sur l'indice de l'IA ?
Articles liés

Quantization : guide pour maximiser le débit des modèles 1

Exécution locale: Comment utiliser la quantification des LLM 2
Comparer les modèles : guide pour choisir la bonne taille 4 bits
Qwen ou Llama 3.1 : Quel modèle choisir pour votre PC local ?
Articles populaires
Comparer les modèles : guide pour choisir la bonne taille 4 bits
Exécution locale: Comment utiliser la quantification des LLM 2
Llama 3.1 : Boostez votre PC avec une IA privée et gratuite
Commentaires 0