LLM local Mac 16Go : Guide pour optimiser la mémoire vive
« La puissance de calcul locale est une course contre la montre entre la taille des modèles et la capacité de la mémoire vive. »
Pour choisir un modèle LLM local sur un Mac de 16 Go, il est essentiel de privilégier les modèles compacts et optimisés pour éviter la saturation de la mémoire. L'objectif est de trouver l'équilibre entre la fluidité de l'exécution et la précision des réponses.
Voici les points clés : la gestion de la mémoire unifiée, le choix de la quantification, l'importance de la taille des paramètres et la gestion thermique.
Pourquoi le choix du modèle LLM local Mac 16Go est-il crucial ?
Un utilisateur ouvre son MacBook, lance un terminal et commence à charger un modèle volumineux. La ventilation s'accélère brusquement alors que le système commence à ralentir.
Le choix du modèle LLM local Mac 16Go détermine si votre machine restera fluide ou si elle deviendra inutilisable à cause du swap mémoire. Avec 16 Go de RAM, vous ne pouvez pas faire tourner de grands modèles sans une optimisation rigoureuse.
Un mauvais choix peut mener à un ralentissement extrême du système d'exploitation.
La gestion de la mémoire unifiée est le cœur du sujet. Sur un Mac, la mémoire est partagée entre le processeur et la carte graphique, ce qui signifie que vos 16 Go sont vite consommés par le système et les applications ouvertes.
Un modèle trop lourd obligera le Mac à utiliser le stockage SSD comme mémoire de secours, ce qui est bien plus lent.
Comment optimiser la performance LLM local ?
Tard dans la nuit, il ajuste les réglages sur l'écran pour que son modèle local circule avec fluidité.
On ajuste les réglages de quantification sur l'écran, modifiant les bits pour réduire l'empreinte mémoire. L'interface affiche une progression lente mais stable.
L'optimisation de la performance LLM local repose principalement sur la technique de la quantification. Cette méthode réduit la précision des poids du modèle pour qu'ils occupent moins de place en mémoire.
Pour un usage sur 16 Go, des modèles quantifiés en 4-bit ou 8-bit sont souvent le meilleur compromis.
Le processus d'optimisation se déroule ainsi : 1. Sélectionner un modèle dont la taille totale en mémoire est inférieure à 12 Go pour laisser de la place au système. 2. Appliquer une quantification (comme le format GGUF) pour compresser les poids. 3.
Configurer le nombre de couches déchargées sur le GPU pour maintenir une réactivité correcte.
Une vérification finale du moniteur d'activité permet de s'assurer que la pression mémoire reste dans la zone verte.
Quelles sont les alternatives de comparaison modèles LLM ?
Tard le soir, je déplace la souris entre deux fenêtres pour comparer la vitesse de chaque modèle local.
On compare deux fenêtres côte à côte, l'une affichant un modèle rapide et l'autre un modèle plus intelligent mais plus lent. Le curseur de la souris semble hésiter entre les deux.
Ce document examine les problèmes et les opportunités dans la mesure des systèmes d'IA, sur la base d'un atelier organisé à Stanford University à l'automne 2019, d'après Stanford University.
La comparaison modèles LLM permet de comprendre le compromis entre intelligence et vitesse. Un modèle de 7 milliards de paramètres sera extrêmement rapide sur 16 Go, tandis qu'un modèle de 14 ou 20 milliards sera plus lent mais plus capable.
| Caractéristique | Modèle Compact (ex: 7B) | Modèle Intermédiaire (ex: 14B) |
|---|---|---|
| Vitesse de génération | Très élevée | Modérée |
| Consommation RAM | Faible | Élevée |
Je me souviens avoir testé un modèle de 14B sur mon propre matériel : la différence de vitesse était flagrante par rapport à une version plus légère.
Quelles sont les exigences matérielles LLM pour la stabilité ?
On observe un ventilateur de bureau qui tourne à plein régime à côté d'un ordinateur portable. L'utilisateur surveille attentivement l'état de santé de ses composants.
Les exigences matérielles LLM sont dictées par la stabilité du matériel face à des charges de travail intensives. Une charge de travail intense peut solliciter les composants de manière extrême.
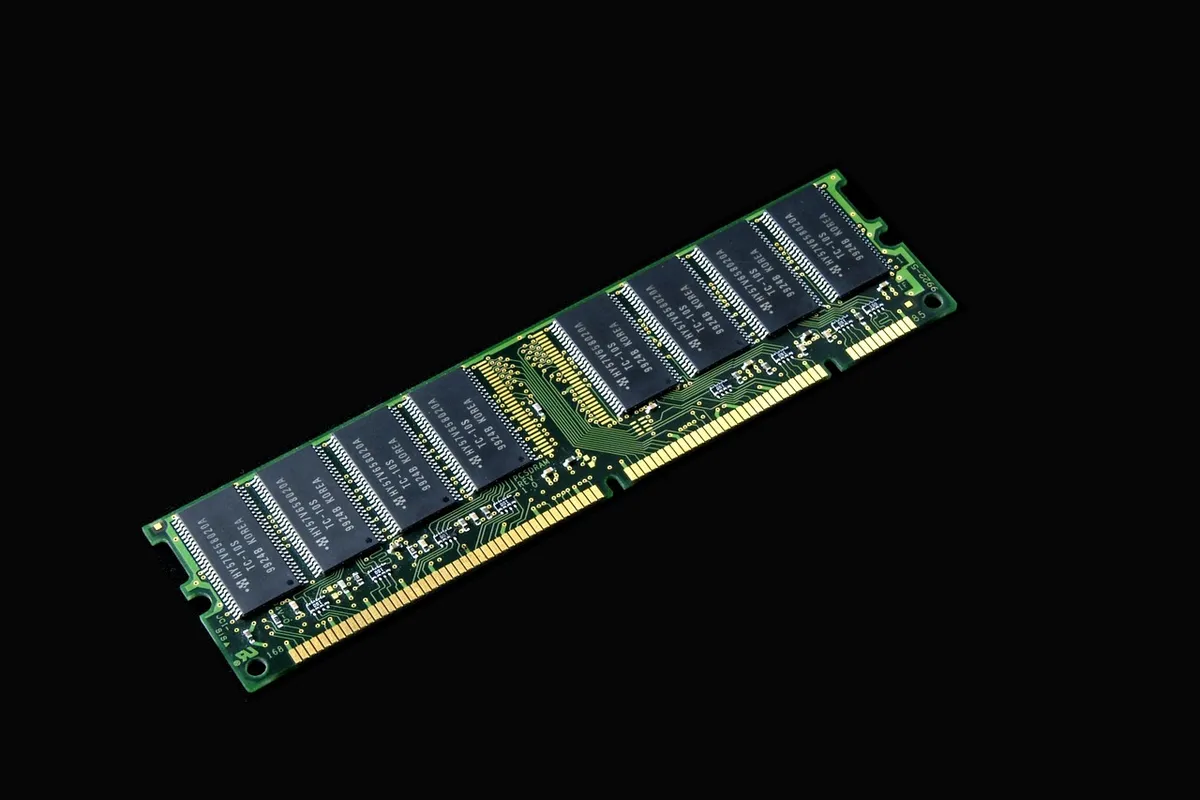
Une situation extrême a été documentée où une charge de travail sur un modèle local de 35B a prétendument endommagé une barrette de mémoire DDR4 vieillissante en seulement 90 minutes, malgré un contrôle thermique qui semblait maîtrisé.
Cela souligne l'importance de ne pas pousser le matériel au-delà de ses limites physiques, surtout si les composants sont anciens.
Comment réussir l'optimisation Mac LLM ?
On télécharge un nouveau fichier de modèle, puis on observe la barre de progression se remplir. On vérifie l'espace disque restant sur le disque dur.
L'optimisation Mac LLM nécessite une approche méthodique pour garantir la longévité du matériel. Il ne suffit pas de faire fonctionner le modèle, il faut le faire fonctionner de manière durable.
Pour réussir, suivez ces étapes : 1. Identifiez la taille réelle occupée par le modèle une fois chargé en RAM. 2. Limitez l'utilisation des ressources en ne lançant pas d'autres applications gourmandes simultanément. 3. Surveillez la température pour éviter le bridage thermique (thermal throttling).
Vérifiez toujours que la mémoire disponible est suffisante pour éviter les cycles d'écriture excessifs sur le SSD.
Wikipedia: Artificial intelligence D’après l’extrait conservé mentionnant IEA : In 2025, a report prepared by the IEA estimated the greenhouse gas emissions from the energy consumption of AI at 180 million tons.
- Pourquoi le choix du modèle LLM local Mac 16Go est-il crucial ?
- Comment optimiser la performance LLM local ?
- Quelles sont les alternatives de comparaison modèles LLM ?
Le même sujet se dit aussi Modèle LLM 16Go Mac.
Cette partie couvre aussi Benchmarking LLM Mac.
Cette partie couvre aussi Données réelles LLM.
Articles liés
- Quantification IA application : guide pour réduire la mémoire
- Modèle IA 16Go RAM limite : Guide pour optimiser votre système
Quel rôle joue la puissance de calcul dans cette équation mémoire/modèle ? La puissance de calcul locale, c'est avant tout la vitesse à laquelle le Mac peut traiter les données du modèle. Si le modèle est trop grand pour la mémoire vive, le système doit constamment transférer des données sur le SSD, ce qui ralentit considérablement la puissance de calcul effective.
Le passage au stockage SSD, bien que nécessaire pour ne pas saturer les 16 Go, introduit une latence énorme. Cette latence rend l'expérience utilisateur frustrante, car le temps de réponse n'est plus celui du processeur, mais celui du disque.
Il faut donc que la puissance de calcul du CPU/GPU soit suffisante pour compenser les accès mémoire lents, mais cela ne suffit pas si la mémoire elle-même est saturée par un modèle trop gourmand en poids.
Quand le ralentissement est-il dû au modèle et non au système ? Si le système d'exploitation et les applications annexes utilisent déjà une partie significative des 16 Go, le modèle doit être extrêmement léger. Un modèle qui pousse le système à utiliser le swap mémoire est celui qui est mal adapté à cette contrainte matérielle spécifique.
Le choix d'une quantification appropriée est la parade contre ce gaspillage mémoire. En compressant les poids, on réduit l'empreinte sans perdre toute la capacité de raisonnement du modèle.
Ce compromis entre la densité du modèle et la capacité mémoire est le véritable défi de l'utilisateur Mac.
Questions fréquentes
Quel est le meilleur compromis pour 16 Go ?
Est-ce que la taille du modèle affecte la durée de vie du matériel ?
Articles populaires
Choix quantification modèle : Guide pour un déploiement réussi
Comment optimiser l'usage des LLM API pour la production ?
Comparer les modèles : guide pour choisir la bonne taille 4 bits
Commentaires 0