Aceleración hardware LLM: guía para la ejecución local LLM
Como la potencia de procesamiento ha crecido de forma exponencial, la elección entre ejecutar modelos de lenguaje de forma local o en la nube define la eficiencia de cualquier proyecto de inteligencia artificial. Este análisis compara la capacidad de procesamiento de hardware frente a la flexibilidad de la nube, centrándose en el rendimiento y la infraestructura. Los puntos clave incluyen la evolución histórica del hardware, la distribución de datos digitales y las diferencias técnicas entre entornos de ejecución.
¿Cómo influye la evolución del hardware en la aceleración hardware LLM?
Un técnico observa cómo los componentes de una estación de trabajo vibran bajo la carga de un modelo complejo. La capacidad de procesamiento ha cambiado drásticamente las reglas del juego en la computación.
Según la información histórica, desde 1986 hasta 2003, la tasa de mejora anual en el rendimiento del hardware superó el 50 por ciento, lo que permitió el desarrollo de nuevos dispositivos informáticos como tabletas y móviles.
Este crecimiento constante es el cimiento que permite hoy intentar la ejecución local LLM. La potencia acumulada en décadas de avances permite que arquitecturas modernas gestionen tareas que antes eran imposcriptibles.
La aceleración hardware LLM se beneficia directamente de este legado de optimización. Sin esa progresión constante, la capacidad de procesar redes neuronales recurrentes o modelos masivos no sería viable en entornos domésticos.
La potencia de cálculo actual es el resultado de esa aceleración constante en el rendimiento de los componentes físicos.
La transición hacia arquitecturas con mayor ancho de banda de memoria y núcleos especializados en operaciones tensoriales permite manejar modelos cada vez más complejos con menor latencia.
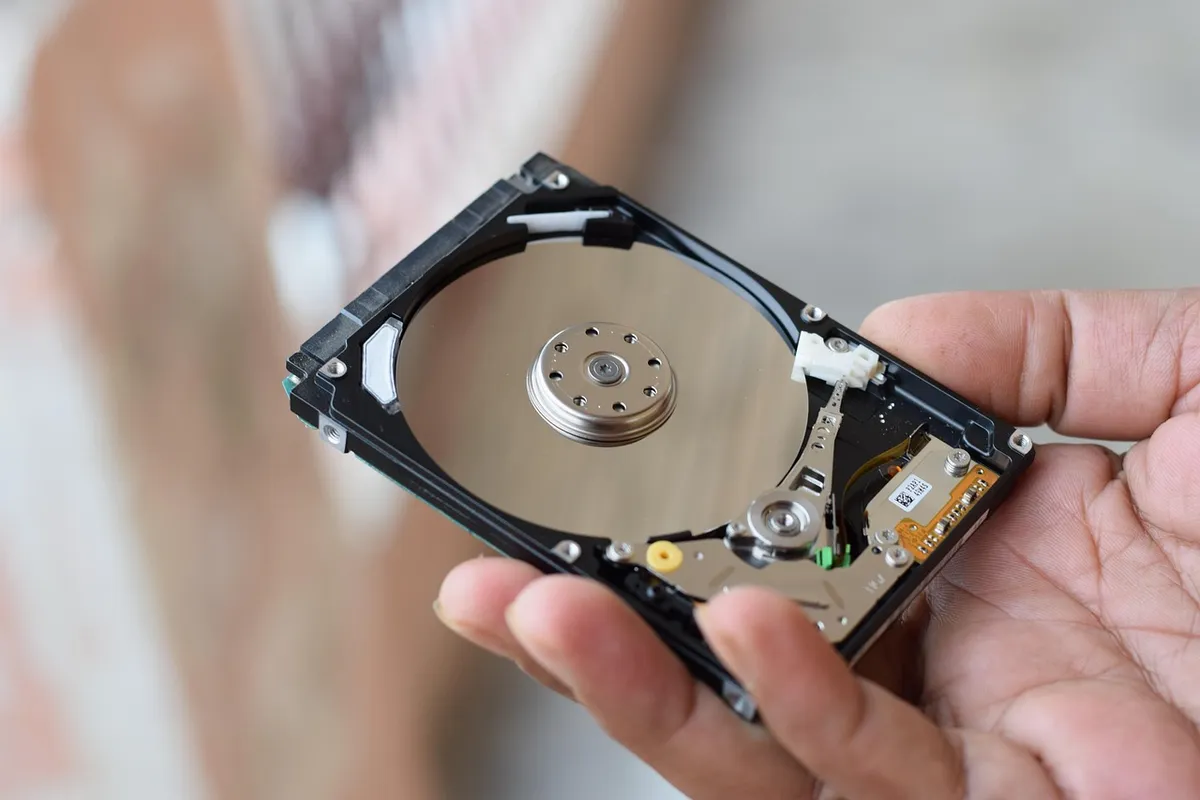
¿Cómo pueden mis datos optimizar mi modelo local? Un ingeniero revisa los discos de almacenamiento en un servidor para asegurar la integridad de los pesos del modelo. La gestión de la información es tan crítica como la capacidad de cómputo.
La relación entre el almacenamiento y el procesamiento es fundamental para entender la eficiencia.
Para contextualizar la escala de la información gestionada, se observa que, a partir de 2007, casi el 94% de los datos almacenados en todo el mundo se mantenía de forma digital: el 52% en discos duros, el 28% en dispositivos ópticos y el 11% en cinta magnética digital.
Esta infraestructura de datos es la que alimenta los modelos que intentamos ejecutar.
La optimización modelo local depende de cómo estos datos se mueven entre el almacenamiento y la unidad de procesamiento. Un rendimiento de cómputo IA eficiente requiere que la velocidad de transferencia no sea un cuello de botella.
La capacidad de mover grandes volúmenes de datos digitales es lo que permite que la inteligencia artificial sea fluida.
La calidad y el formato de los datos determinan la eficiencia de la cuantización, permitiendo que el modelo ocupe menos espacio sin perder precisión crítica.
¿Cómo se compara el rendimiento de cómputo IA entre entornos?
Un usuario cambia entre su ordenador portátil y una interfaz de navegador para probar la velocidad de respuesta. La decisión entre nube y local depende de las necesidades de infraestructura.
La comparativa entornos IA se resume en la disponibilidad de recursos frente al control total. Mientras que el entorno local ofrece privacidad y latencia mínima, la nube ofrece una escalabilidad casi ilimitada.
La eficiencia ejecución modelo varía según si el cuello de botella es la memoria de video o el ancho de banda de red.
| Factor de comparación | Ejecución Local | Solución en la Nube |
|---|---|---|
| Control de recursos | Total sobre el hardware | Limitado por el proveedor |
| Escalabilidad | Limitada por la capacidad física | Dinámica y bajo demanda |
Esta tabla muestra las diferencias estructurales. En la práctica, la elección depende de si se busca estabilidad o capacidad de expansión inmediata.
Mientras que los entornos de escritorio ofrecen flexibilidad, los entornos de servidor proporcionan una densidad de cómputo necesaria para el entrenamiento paralelo.
¿Qué aspectos técnicos determinarán la eficiencia de mi IA? Un desarrollador ajusta los parámetros de una red neuronal en una terminal de comandos. La arquitectura interna determina cómo se distribuye la carga de trabajo.
Existen estructuras específicas que optimizan el procesamiento. Por ejemplo, la red de estado de eco (ESN) es una red neuronal recurrente con una capa oculta conectada de forma dispersa (con una conectividad típicamente del 1%).
Este tipo de arquitecturas eficientes es lo que se busca al trasladar modelos a hardware específico.
La eficiencia ejecución modelo también puede verse afectada por modelos de datos. El Marco de Descripción de Recursos (RDF) es una familia de especificaciones del World Wide Web Consortium (W3C) diseñadas originalmente como un modelo de datos de metadatos.
El manejo inteligente de estos metadatos y estructuras es vital para la interoperabilidad entre diferentes sistemas de IA.
La eficiencia se define por el equilibrio entre el consumo energético, el uso de la VRAM y la velocidad de procesamiento de los núcleos de la GPU.
¿Cuáles son los pasos para implementar una solución de hardware?
Un técnico instala una nueva tarjeta gráfica en un chasis de servidor con cuidado. La implementación requiere un orden lógico para evitar fallos de rendimiento.
Para establecer una infraestructura de inteligencia artificial, se deben seguir ciertos pasos fundamentales:
- Evaluación de la carga de trabajo: Determinar la magnitud de los parámetros del modelo para seleccionar el hardware adecuado. 2. Configuración de la conectividad: Asegurar que la transferencia de datos entre el almacenamiento y el procesador sea óptica o de alta velocidad. 3. Verificación de la estabilidad: Realizar pruebas de estrés para asegurar que el sistema soporte la carga térmica y eléctrica.
Un chequeo final de la integridad de los datos asegura que la carga de trabajo sea constante. La gestión de recursos computacionales IA requiere esta preparación previa para evitar interrupciones.
- Evaluación de los requisitos de memoria para el tamaño del modelo. 2. Selección de la arquitectura de procesamiento compatible. 3. Configuración del sistema de refrigeración y suministro energético.
¿Qué limitaciones existen en la aceleración de hardware?
Un ventilador de refrigeración se activa al máximo cuando el sistema alcanza su límite de potencia. Las condiciones físicas imponen límites reales a la capacidad de procesamiento.
Según la National Highway Traffic Safety Administration, en febrero de 2011 se presentaron los resultados de un estudio de 10 meses realizado por la National Highway Traffic Safety Administration (NHTSA) y la National Aeronautics and Space Administration (NASA), con el objetivo de identificar la causa principal de la aceleración repentina en modelos Toyota y Lexus.
De acuerdo con la National Aeronautics and Space Administration, en febrero de 2011 se presentaron los resultados de un estudio de 10 meses realizado por la National Highway Traffic Safety Administration (NHTSA) y la National Aeronautics and Space Administration (NASA), con el objetivo de identificar la causa principal de la aceleración repentina en modelos Toyota y Lexus.
La implementación de estas soluciones no es universalmente sencilla. Una limitación importante es la carga térmica y de energía; por ejemplo, con el acelerador ajustado deliberadamente al 80% de su velocidad máxima, cada vehículo pudo frenar de forma segura hasta detenerse.
Este tipo de restricciones de seguridad y rendimiento son aplicables al manejo de cargas extremas en hardware de computación.
La capacidad de procesamiento no es infinita y está sujeta a las leyes de la física. Un exceso de carga puede comprometer la integridad de los componentes si no se gestiona correctamente.
- ¿Cómo influye la evolución del hardware en la aceleración hardware LLM?
- ¿Cómo pueden mis datos optimizar mi modelo local?
- ¿Cómo se compara el rendimiento de cómputo IA entre entornos?
Artículos relacionados
Preguntas frecuentes
¿Cómo afectó el crecimiento del hardware a los dispositivos actuales?
¿Cómo se distribuía el almacenamiento digital en 2007?
Publicaciones relacionadas
IA como herramienta dev: Guía para flujo trabajo IA y recursos
¿Cuál es la diferencia entre modelos abiertos y cerrados?
LLM híbrido en la nube: guía para optimizar recursos 97%
IA multimodal comercial: Consejos para modelos de 7B y parámetros
Publicaciones populares
¿Cómo optimizar el rendimiento de la API en entornos reales?
Cómo usar IA: Guía para modelos especializados en tareas críticas
¿Cuál es la diferencia entre modelos abiertos y cerrados?
Comentarios 0