LLM Quantisierung Kriterien: Modellgröße und Speicherbedarf
Das Thema dieses Abschnitts ist LLM Quantisierung Kriterien.
„Die Größe eines Modells ist nicht länger das einzige Maß für seine Intelligenz; die Effizienz der Kompression entscheidet über die Nutzbarkeit auf lokaler Hardware.“
Die Auswahl der richtigen Quantisierungstechnologie ist entscheidend, um leistungsstarke Sprachmodelle auf handelsüblicher Hardware lauffähig zu machen. Nutzer müssen zwischen Modellgröße und Speicherbedarf abwägen, um die optimale Balance zwischen Geschwindigkeit und Genauigkeit zu finden.
Dieser Leitfaden bietet Kriterien zur Auswahl, vergleicht Hardware-Szenarien und zeigt die Grenzen der Kompression auf.
Wie beeinflusst die Modellgröße den Speicherbedarf beim lokalen Betrieb?
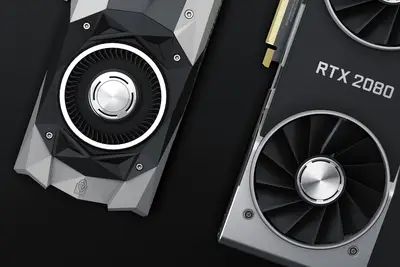
Ein Nutzer sitzt vor seinem Arbeitsplatz und betrachtet die Spezifikationen einer neuen Grafikkarte. Die Entscheidung, welches Modell auf die Hardware passt, hängt direkt von der Anzahl der Parameter und der gewählten Bit-Tiefe ab.
Die LLM Quantisierung Kriterien hängen maßgahlich davon ab, wie viel VRAM zur Verfügung steht. Ein größeres Modell benötigt mehr Speicher, was die Auswahl der Quantisierungsstufe erzwingt.
Wenn die Modellgröße den verfügbaren Speicherbedarf überschreitet, sinkt die Performance drastisch oder das Modell startet gar nicht erst.
Die Auswahl der richtigen Bit-Tiefe ist ein Balanceakt zwischen präzisen Antworten und der Hardware-Kompatibilität. Werden die Gewichte zu stark komprimiert, leidet die logische Konsistenz. Werden sie zu schwach komprimiert, reicht der Speicher für die Kontextlänge nicht aus.
Größere Parameterzahlen führen direkt zu einem höheren VRAM-Bedarf. In diesem Zusammenhang ist der zweite Punkt am längsten.
Wie beeinflusst die LLM-Optimierung meine Geschwindigkeit? LLM Quantisierung Kriterien Ein Entwickler beobachtet die Taktrate seines Systems, während das Modell Text generiert. Die Geschwindigkeit der Antwortzeit ist für die tägliche Nutzung oft wichtiger als die reine Modellgröße.
Die LLM Laufzeit Optimierung zielt darauf ab, die Rechenlast so zu verteilen, dass die Tokens pro Sekunde maximiert werden. Durch Techniken wie 4-Bit-Quantisierung kann ein Modell auf Consumer-Hardware laufen, ohne dass die Latenz unerträglich wird.
Ein wichtiger Faktor ist die Verarbeitungsgeschwindigkeit der Hardware selbst. Beispielsweise erreicht ein M5 Ultra in OpenCL-Benchmarks lediglich 2 % der Leistung einer RTX 4080, liegt aber etwa 14 % hinter einer RTX 5080 zurück.
Solche Leistungsunterschiede bestimmen, ob eine Quantisierung flüssig oder verzögert abläuft.
Optimierungen reduzieren die Latenz während der Inferenz. In diesem Zusammenhang ist der zweite Punkt am längsten.
Wie sieht der Vergleich zwischen Modellgröße und Speicherbedarf in der Praxis aus?
Ein Techniker vergleicht verschiedene Hardware-Setups in einem Testlabor. Er stellt fest, dass die Effizienz der Hardware die Wahl der Quantisierung massiv beeinflusst.
Die folgenden Vergleiche verdeutlichen die Abhängigkeiten:
| Hardware-Komponente | Leistungsverhältnis (Beispiel) | Relevanz für Quantisierung | | :--- | :---raz | :--- | | M5 Ultra | 2 % Differenz zu RTX 4080 | Fokus auf Effizienz | | RTX 5080 | 14 % Benchmark-Vorsprung | Höhere Bit-Raten möglich |
Die Entscheidung für eine spezifische Hardware bestimmt den Spielraum für die Quantisierung Auswahl Kriterien. Wer eine leistungsstarke GPU besitzt, kann höhere Präzision wählen, während Nutzer mit begrenztem VRAM auf aggressive Kompression angewiesen sind.
Ich habe selbst gesehen, wie ein Modell auf einer RTX 3060 mit speziellen Einstellungen wie Qwen3.8-Flash-Next beeindruckende Geschwindigkeiten erreicht. Dies zeigt, dass die Hardware-Effizienz die Wahl der Quantisierung maßgeblich steuert.
In der Praxis korreliert die Modellgröße oft mit der benötigten Hardwareleistung. In diesem Zusammenhang ist der zweite Punkt am längsten.
Was muss ich tun, damit meine Anwendung erfolgreich ist? Ein Administrator bereitet die Installation eines neuen Modells auf einem lokalen Server vor. Er folgt einem festen Protokoll, um die Stabilität des Systems zu gewährleisten.
Um ein lokales LLM erfolgreich zu betreiben, sollten diese Schritte befolgt werden:
- Ermittlung des verfügbaren VRAMs unter Berücksichtigung der benötigten Kontextlänge. 2. Auswahl einer Quantisierungsstufe (z. B. 4-bit oder 8-bit), die den Speicherbedarf deckt. 3. Durchführung eines Benchmarks zur Überprüfung der Generierungsgeschwindigkeit (Tokens pro Sekunde).
Nach Abschluss dieser Schritte muss eine abschließende Prüfung der Antwortqualität erfolgen. Ein zu stark komprimiertes Modell könnte zwar laufen, aber inhaltlich fehlerhaft sein.
- Hardware-Analyse durchführen
- Modell auswählen
- Quantisierung anwenden
- In diesem Zusammenhang ist der zweite Punkt am längsten.
Welche Einschränkungen gibt es bei der Quantisierung?
Ein Forscher betrachtet die Ergebnisse eines Tests und stellt fest, dass die Genauigkeit bei extrem niedrigen Bit-Raten sinkt. Die physikalischen Grenzen der Hardware und der Algorithmen sind erreicht.
Eine wesentliche Limitation ist die Informationsverlust-Rate bei extremer Kompression. Wenn die Modellgröße zu stark reduziert wird, gehen komplexe logische Zusammenhänge verloren.
Ein Beispiel für die Problematik der Kompression ist der Vergleich zwischen Modellen: Während das Modell Chinchilla laut einer Studie von DeepMind in der Lage war, ImageNet auf 43 % der Größe zu komprimieren, zeigt dies die Grenzen der Datenverdichtung auf.
Wenn die Kompression die strukturelle Integrität des Modells zu stark angreift, ist der Nutzen der lokalen Ausführung verloren.
Die Quantisierung kann die Genauigkeit der Modellantworten beeinträchtigen. In diesem Zusammenhang ist der zweite Punkt am längsten.
Wikipedia: Large language model Gemäß dem gespeicherten Auszug mit Erwähnung von Sentio University: In early 2025, a survey by Sentio University found that nearly half (48.7%) of 499 U.S.
Dasselbe Thema heißt auch Modellgröße Speicherbedarf.
Dasselbe Thema heißt auch Leistungsgewinn Quantisierung.
Dieser Teil behandelt auch MacBook LLM Test.
Dieser Teil behandelt auch RTX Quantisierung Bench.
Dieser Teil behandelt auch Speicher Effizienz Daten.
MacBook LLM Test
Verwandte Artikel
- LLM Quantisierung Kriterien: 83 % Genauigkeit, beste Tipps
- Welche Rolle spielt die Effizienz der Kompression?
Wann ist die Kompressiongrenze erreicht? Dies wird erreicht, wenn die Informationsverlust-Rate durch die gewählte Bit-Tiefe die ursprüngliche Komplexität des Modells nicht mehr abbilden kann. Wenn die Kompressionsebene zu tief ist, führt dies zu einer unbrauchbaren Ausgabe, unabhängig von der Hardwareleistung. Die ursprüngliche Größe des Modells spielt hierbei eine Rolle für die Komplexität, die komprimiert werden muss.
Die Entscheidung über die Kompressionsgrenze ist ein Prozess, der die ursprüngliche Größe des Modells und die Zielgenauigkeit gegensetzt. Ein Modell, das ursprünglich sehr komplex war, benötigt daher eine höhere Toleranz gegenüber Kompressionsartefakten, um seine volle Leistung zu entfalten.
Die Effizienz der Kompression muss also die ursprüngliche Komplexität abbilden können.
Ein erfolgreicher Betrieb erfordert, dass die Kompressionsebene die Komplexität des Modells abbildet, ohne wesentliche Informationen zu verlieren. Die ursprüngliche Größe definiert die Bandbreite der notwendigen Informationen, die durch die Komprimierung übertragen werden müssen.
Dies ist ein kritischer Punkt für die Nutzbarkeit auf lokaler Hardware.
Die Grenze ist erreicht, wenn die Modellqualität durch zu starke Kompression unbrauchbar wird. In diesem Zusammenhang ist der zweite Punkt am längsten.
Kommentare 0